LARE-HPA
Summary
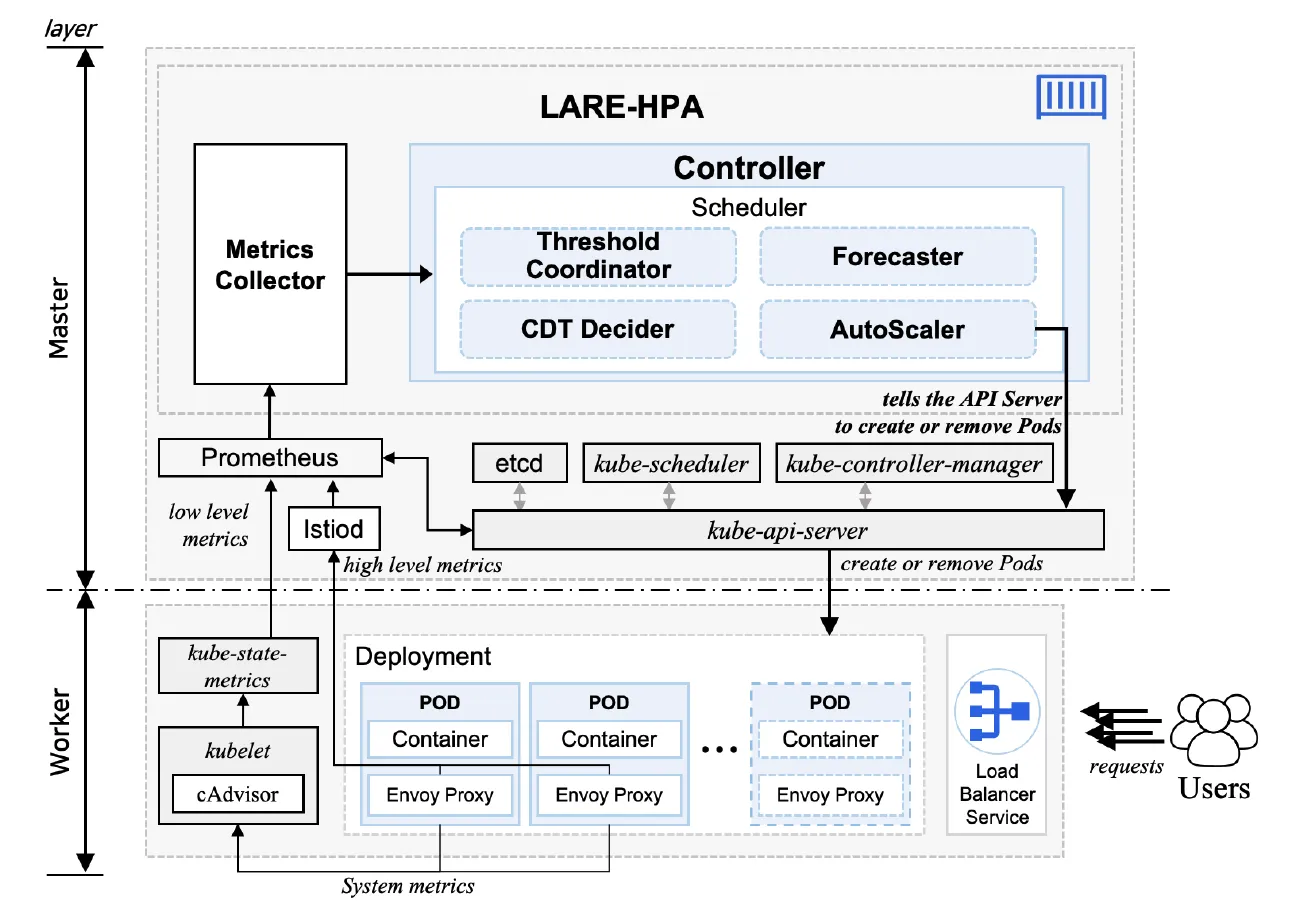
요청 변화에 따라 CPU Threshold와 Cool Down Time을 조정하는 Kubernetes 오토스케일러입니다. 별도의 사전 학습 없이 요청 예측을 갱신하고, 확장 시점과 자원 반환 시점을 함께 조정하도록 설계해 Python 컨트롤러로 구현했습니다.
- Role
- 제1저자 (기법 설계와 구현, 실험)
- Stack
- Python, Kubernetes, Istio, Prometheus
- Outcome
- ICSOC 2024 Distinguished Paper Award, 특허 출원, SW 저작권 등록
문제 정의
부하가 달라지는데, 스케일링 기준은 그대로였습니다
Kubernetes의 기본 오토스케일러인 HPA는 CPU 사용률과 설정한 Threshold를 비교해 파드 수를 조절합니다. Threshold를 낮게 잡으면 파드를 일찍 늘려 응답 지연을 줄일 수 있지만, 같은 요청을 처리하는 데 더 많은 자원이 필요합니다. 높게 잡으면 자원을 더 채워 쓸 수 있어도, 새 파드가 준비되는 동안 요청이 밀릴 수 있었습니다. 응답 지연과 자원 효율을 함께 만족시키려면 어느 한쪽으로 값을 고정하는 것으로는 부족했습니다.
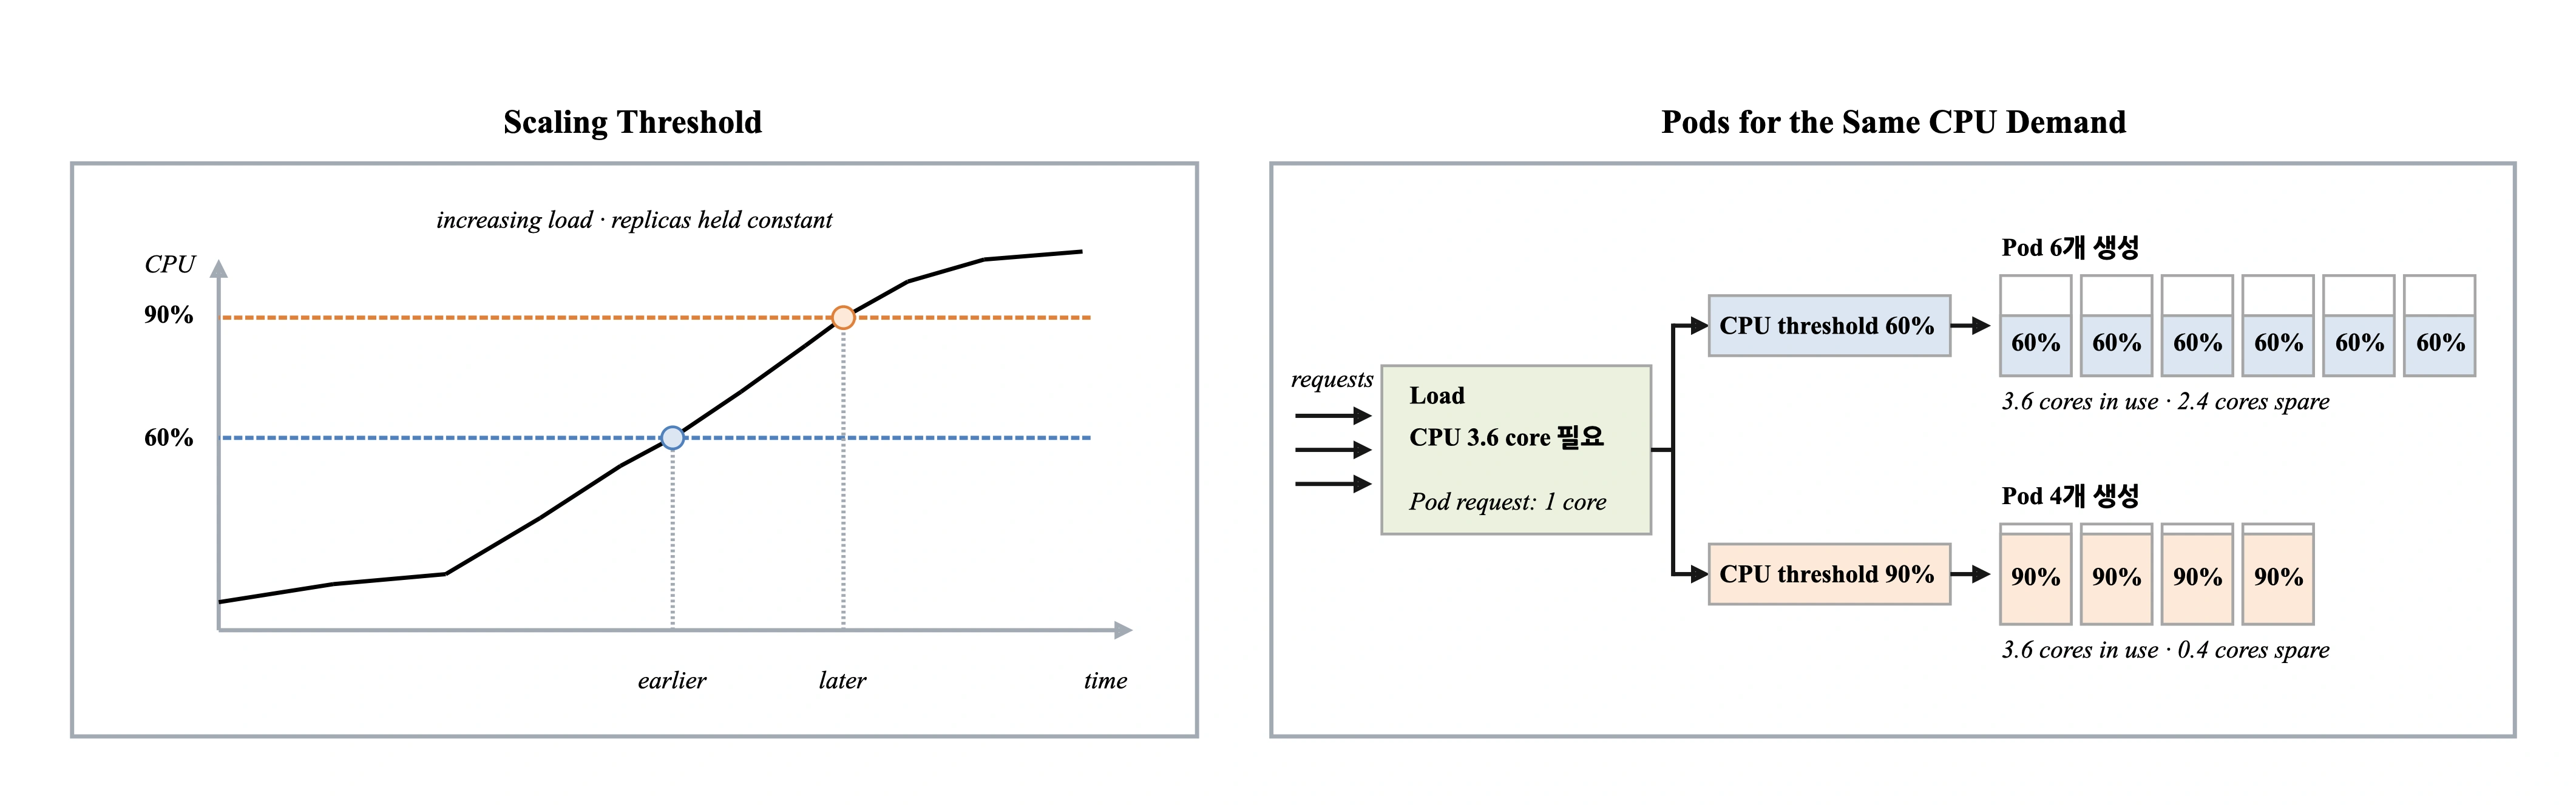
먼저 Threshold에 따른 차이를 실험했습니다. 60% 설정의 평균 CPU 할당량은 1,280.0 millicore, 90% 설정은 1,046.15 millicore로 약 22% 차이가 났습니다. 요청이 안정적인 구간과 급변하는 구간에 같은 기준을 적용할 때 생기는 비용을 확인한 비교였습니다.
파드를 줄이는 시점에도 비슷한 문제가 있었습니다. Cool Down Time을 짧게 두면 잠깐 줄어든 요청에 맞춰 해제한 파드를 곧 다시 늘리는 flapping이 발생할 수 있습니다. 길게 두면 요청이 줄어든 뒤에도 자원을 오래 유지합니다. 확장에 필요한 여유와 축소 전 기다릴 시간을 부하 변화에 맞춰 각각 조정할 필요가 있었습니다.
설계 방향
사전 학습을 기다리지 않고, 들어오는 요청으로 갱신하도록
기준을 조정하려면 현재 CPU 사용률에 더해 요청이 어떻게 달라지는지도 알아야 했습니다. 다만 신규 애플리케이션에는 학습에 쓸 이력이 충분하지 않고, 미리 학습한 모델도 요청 패턴이 달라지면 다시 학습해야 합니다. 서비스 실행 중 쌓이는 데이터로 예측을 계속 갱신하는 온라인 학습 방식을 선택했습니다.
Forecaster에는 Online ARIMA를 적용했습니다. 과거 요청과 오차의 관계를 다루는 ARIMA를 온라인 자기회귀 모델로 근사하고, 새로운 관측값이 들어올 때마다 Online Newton-Step으로 계수를 갱신했습니다. 별도의 학습 단계를 반복하지 않고 다음 구간의 요청량을 예측하기 위한 선택입니다.
예측값은 실제 요청 변화와 함께 Threshold를 조정하는 데 사용했습니다. 실제 Replica 수는 현재 CPU 사용률과 조정한 Threshold로 계산하도록 역할을 나눴습니다. 초기 관측값이 쌓이는 동안에는 설정한 Threshold를 유지하고, 예측 준비가 끝난 뒤 조정값을 반영하도록 구현했습니다.
설계 #1
요청의 변동성이 커질수록 scale-out을 앞당기도록
같은 요청 증가량도 평소 트래픽 규모와 변화 폭에 따라 의미가 달라집니다. Threshold Coordinator는 최근 요청의 변화와 다음 구간 예측값을 함께 보고, 현재 변동성이 과거에 비해 얼마나 큰지 판단하도록 설계했습니다.
최근 10개 구간의 요청 변화와 예측값을 반영한 변화 수준을 z-score로 표준화했습니다. 이어 역 시그모이드 함수로 CPU Threshold 범위에 매핑했습니다. 상한이 정해져 있지 않은 요청량을, CPU 사용률 기준으로 적용할 수 있는 값으로 바꾸는 과정입니다. 실험에서는 50~95% 범위를 사용했습니다.
변동성이 과거보다 크면 Threshold를 낮춰 자원을 일찍 확보하고, 작으면 높여 기존 파드를 더 활용하도록 했습니다. 같은 요청량에서도 최근 변화 양상에 따라 스케일링 기준이 달라지는 구조입니다. 예측과 관측을 함께 반영해, 실제로 발생한 요청 변화도 다음 판단에 이어지게 했습니다.
설계 #2
잠깐 줄어든 요청에 파드를 너무 일찍 반환하지 않도록
Threshold가 scale-out의 시점을 바꾼다면, Cool Down Time은 줄여도 되는 자원을 언제 반환할지 정하는 기준입니다. 전체적으로 요청이 늘고 있다면 잠깐의 감소를 기다려야 하고, 줄고 있다면 불필요한 파드를 오래 유지하지 않아야 했습니다.
CDT Decider는 최근 60개 관측값에 선형 회귀를 적용해 요청의 증감 방향을 구했습니다. 회귀선과 실제 관측값의 차이인 잔차도 Durbin-Watson 통계량으로 확인했습니다. 잔차의 자기상관이 설정한 허용 범위에 들어올 때만 추세를 반영하고, 상승이면 목표 대기 카운터를 늘리고 하강이면 줄이도록 했습니다.
대기 시간은 지표 수집 주기를 몇 번 기다릴지 나타내는 카운터로 관리했습니다. 다음 판단에 사용할 목표값과 현재 남은 횟수를 나눠 두고, 매 주기 남은 횟수를 줄였습니다. scale-in은 이 카운터가 끝났고 CDT Decider가 상승 방향을 반환하지 않을 때만 허용했습니다. scale-out은 필요한 Replica 수가 더 많으면 대기 카운터와 관계없이 요청하도록 했습니다.
구현
조정한 기준을 실제 Kubernetes 스케일링으로 연결
두 조정 경로가 실제 파드 수 변경으로 이어지도록 Python 컨트롤러를 구현했습니다. 하나의 Pod 안에서 요청 예측과 Threshold 조정, Cool Down Time 조정, 실제 스케일링을 세 개의 비동기 프로세스로 나눠 실행했습니다. 조정값을 읽고 갱신할 때는 공유 락을 사용했습니다.
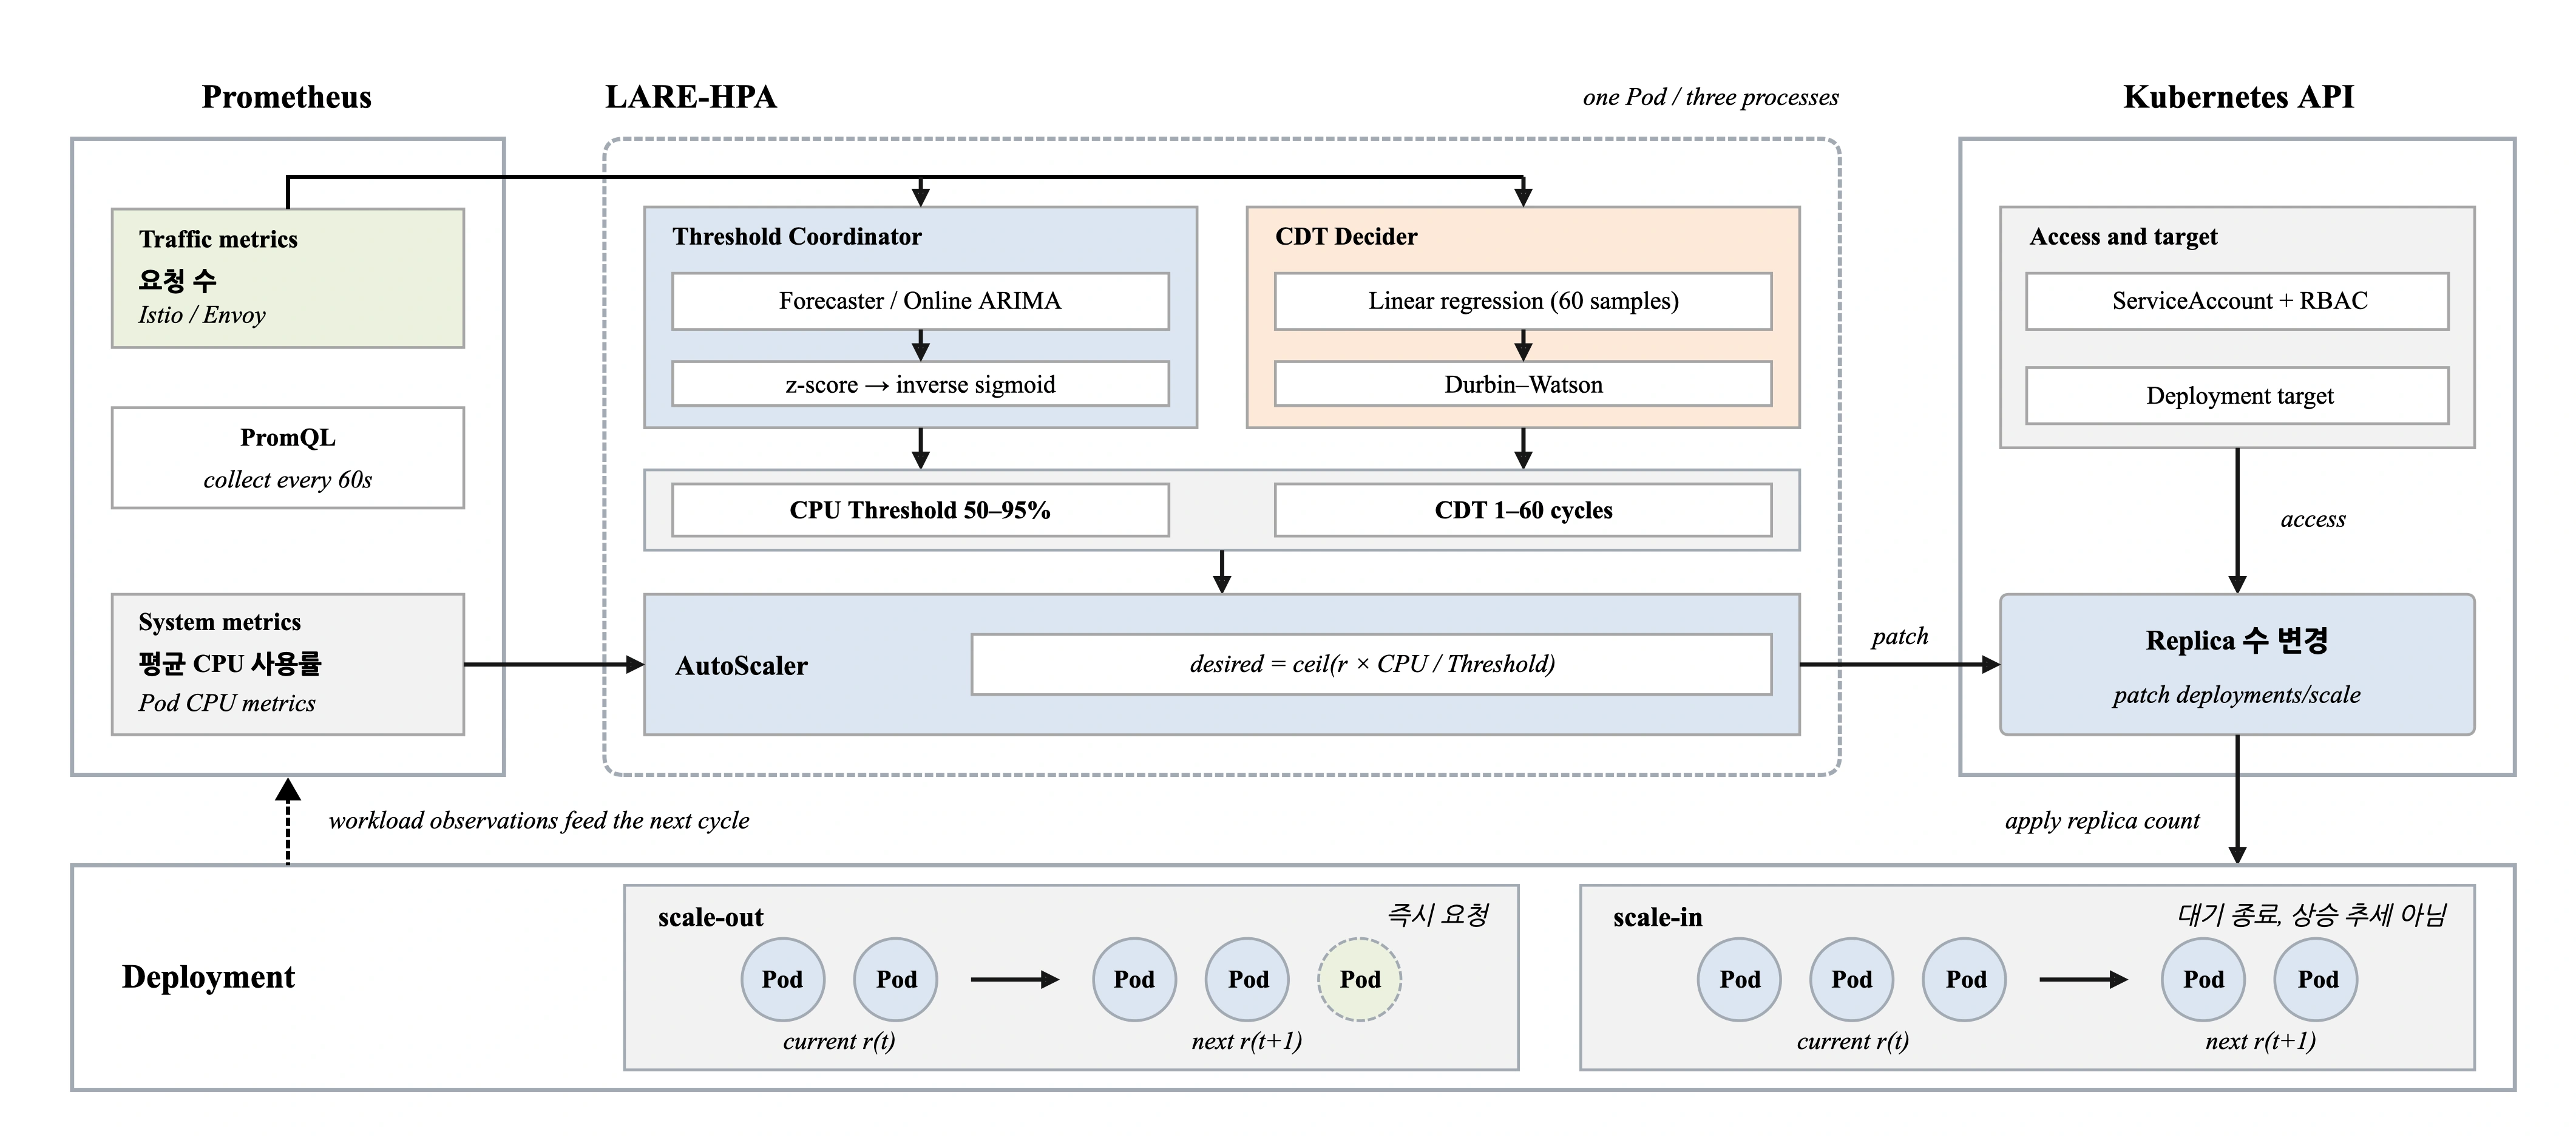
Prometheus에 모인 시스템 지표와 Istio의 요청 지표를 주기적으로 조회했습니다. AutoScaler는 현재 Replica 수에 평균 CPU 사용률과 조정한 Threshold의 비율을 곱해 올림한 뒤, 최소와 최대 Replica 범위로 제한했습니다. 이어 확장과 축소 조건을 확인하고 Kubernetes API로 Deployment의 Replica 수를 변경했습니다.
컨트롤러는 애플리케이션과 분리된 컨테이너로 배포했습니다. 대상 애플리케이션과 Prometheus 주소, 초기 Threshold, Replica 범위, 수집 주기는 ConfigMap으로 지정하고, ServiceAccount와 RBAC으로 API 접근 권한을 설정했습니다. 대상 애플리케이션과 독립적으로 동작하도록 구성해, 애플리케이션 코드를 수정하지 않고도 다양한 애플리케이션에 적용할 수 있게 했습니다.
예측 요청량과 Threshold, Cool Down Time, 스케일링 판단과 오류를 로그로 남겼습니다. 파드 수가 바뀌었다는 결과에 더해 어떤 관측값과 조정 기준이 그 판단으로 이어졌는지 확인할 수 있도록 했습니다.
검증과 결과
같은 요청 이력에서 지연과 자원 할당을 함께 비교
Intel Core i9-10900K와 32 GiB 메모리의 Master 및 Worker 환경에서, 삼각함수를 계산하는 PHP 애플리케이션에 NASA-HTTP의 요청 패턴을 재현했습니다. 응답 시간 1초를 SLO로 정하고, 요청이 급변하는 구간을 포함해 응답 지연과 목표를 만족한 요청의 비율을 비교했습니다.
비교군은 기본 HPA, 사전 학습 기반 Bi-LSTM, 온라인 베이지안 최적화 기반 Online-BO입니다. Bi-LSTM은 워크로드의 50%로 학습하고 파드당 요청 처리 기준을 50건으로 두었습니다. LARE-HPA는 Threshold 관측 구간 10개와 CDT 관측 구간 60개를 사용했고, 다른 비교군은 각 원문의 설정을 따랐습니다. 고정 기준, 사전 학습, 온라인 최적화와 비교해 설계의 차이가 결과로 이어지는지 확인했습니다.
이 실험에서 LARE-HPA는 네 방식 중 평균 응답 지연이 가장 낮고 SLO 만족률이 가장 높았습니다. 기본 HPA 대비 평균 지연은 562.8ms에서 279.5ms로 50.34% 줄었고, P95 지연도 1,189.0ms에서 600.1ms로 낮아졌습니다. SLO 만족률은 93.86%에서 97.24%로 3.38%p 높아졌습니다.
| Method | 평균 지연 (ms) | P95 지연 (ms) | 평균 CPU 할당량 (millicore) | SLO 만족률 (%) |
|---|---|---|---|---|
| HPA | 562.8 | 1189.0 | 582.76 | 93.86 |
| LARE-HPA | 279.5 | 600.1 | 638.13 | 97.24 |
| Bi-LSTM | 462.1 | 1062.6 | 875.85 | 93.06 |
| Online-BO | 519.3 | 966.3 | 1274.75 | 95.15 |
요청이 급증한 구간에서는 비교군의 대응 차이도 드러났습니다. Bi-LSTM은 학습한 패턴을 벗어난 요청에서 필요한 파드 수를 충분히 확보하지 못했습니다. Online-BO 역시 P90 지연이 P50 지연의 두 배를 넘는 조정 조건을 충족하기 전까지 요청 증가에 대응하지 못하는 구간이 있었습니다. 요청 변화로 Threshold를 조정하고 상승 추세에서는 파드를 유지하는 설계가 필요한 이유를 결과에서도 확인했습니다.
자원 할당량은 응답 지연과 함께 해석했습니다. 기본 HPA가 가장 적은 CPU를 할당했고, LARE-HPA는 그보다 자원을 더 쓰면서 지연과 SLO를 개선했습니다. 두 학습 및 최적화 비교군보다 적은 평균 CPU 할당량으로 가장 낮은 평균 지연을 얻었다는 점에서, 응답 성능과 자원 할당의 균형을 확인했습니다.
연구 성과
고정된 설정을 관측에 따라 조정하는 제어 규칙으로
이 연구에서 얻은 관점은 확장과 축소의 판단을 나눠 설계해야 한다는 것이었습니다. 급변하는 요청에 대응할 여유와, 잠시 줄어든 부하를 기다릴 시간은 서로 다른 문제였습니다. 변동성과 추세를 각 판단의 입력으로 두고, 응답 지연과 자원 할당을 함께 최적화하는 방식으로 풀었습니다.
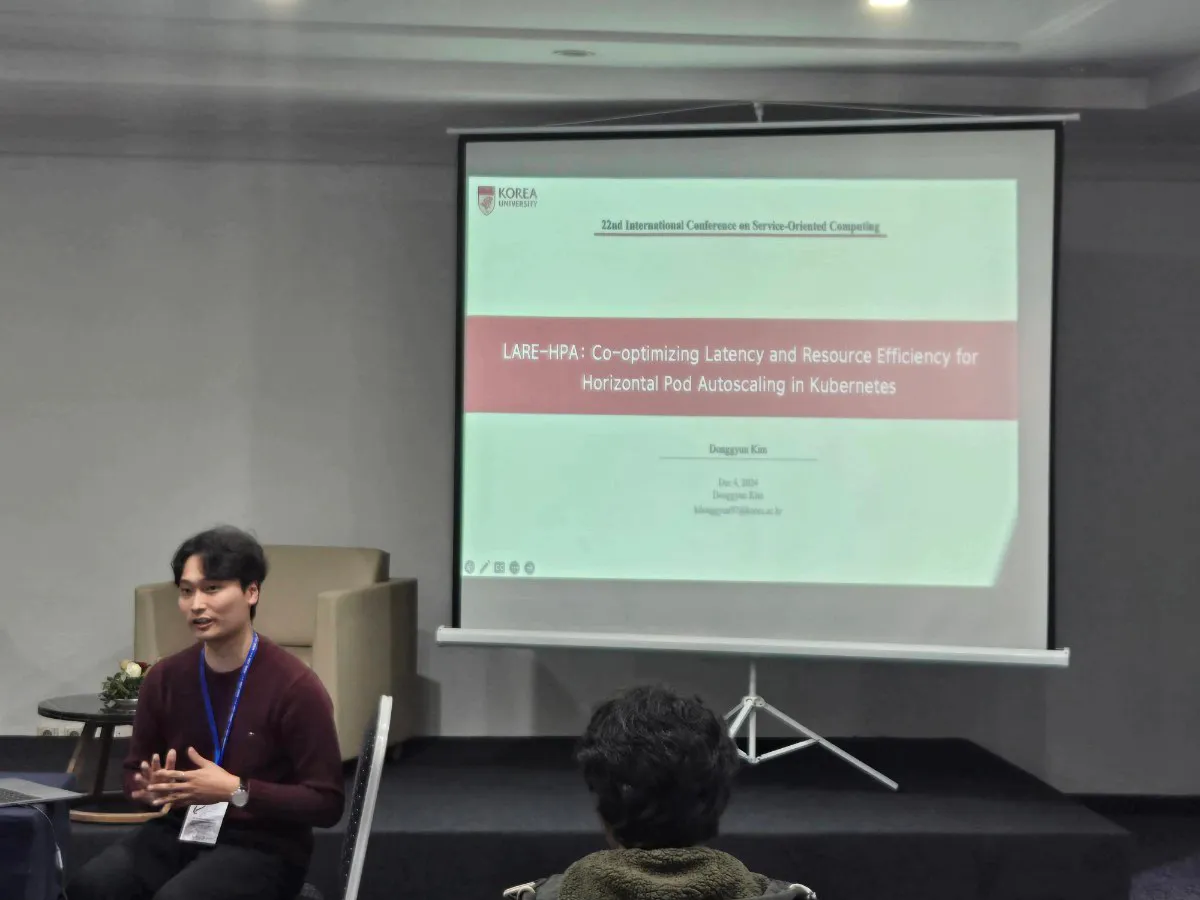
이 연구는 ICSOC 2024에 게재돼 Distinguished Paper Award를 받았습니다. 2024년 12월 Tunis, Tunisia에서 열린 학회에서 LARE-HPA의 설계와 실험 결과를 직접 발표했습니다.
특허 출원(10-2024-0128875)과 소프트웨어 저작권 등록(C-2024-043831)을 마쳤고, 구현 코드는 오픈소스로 공개했습니다.
알고리즘의 수식과 전체 실험 조건은 논문 원문에서 확인할 수 있습니다.