RAG Knowledge Base
Summary
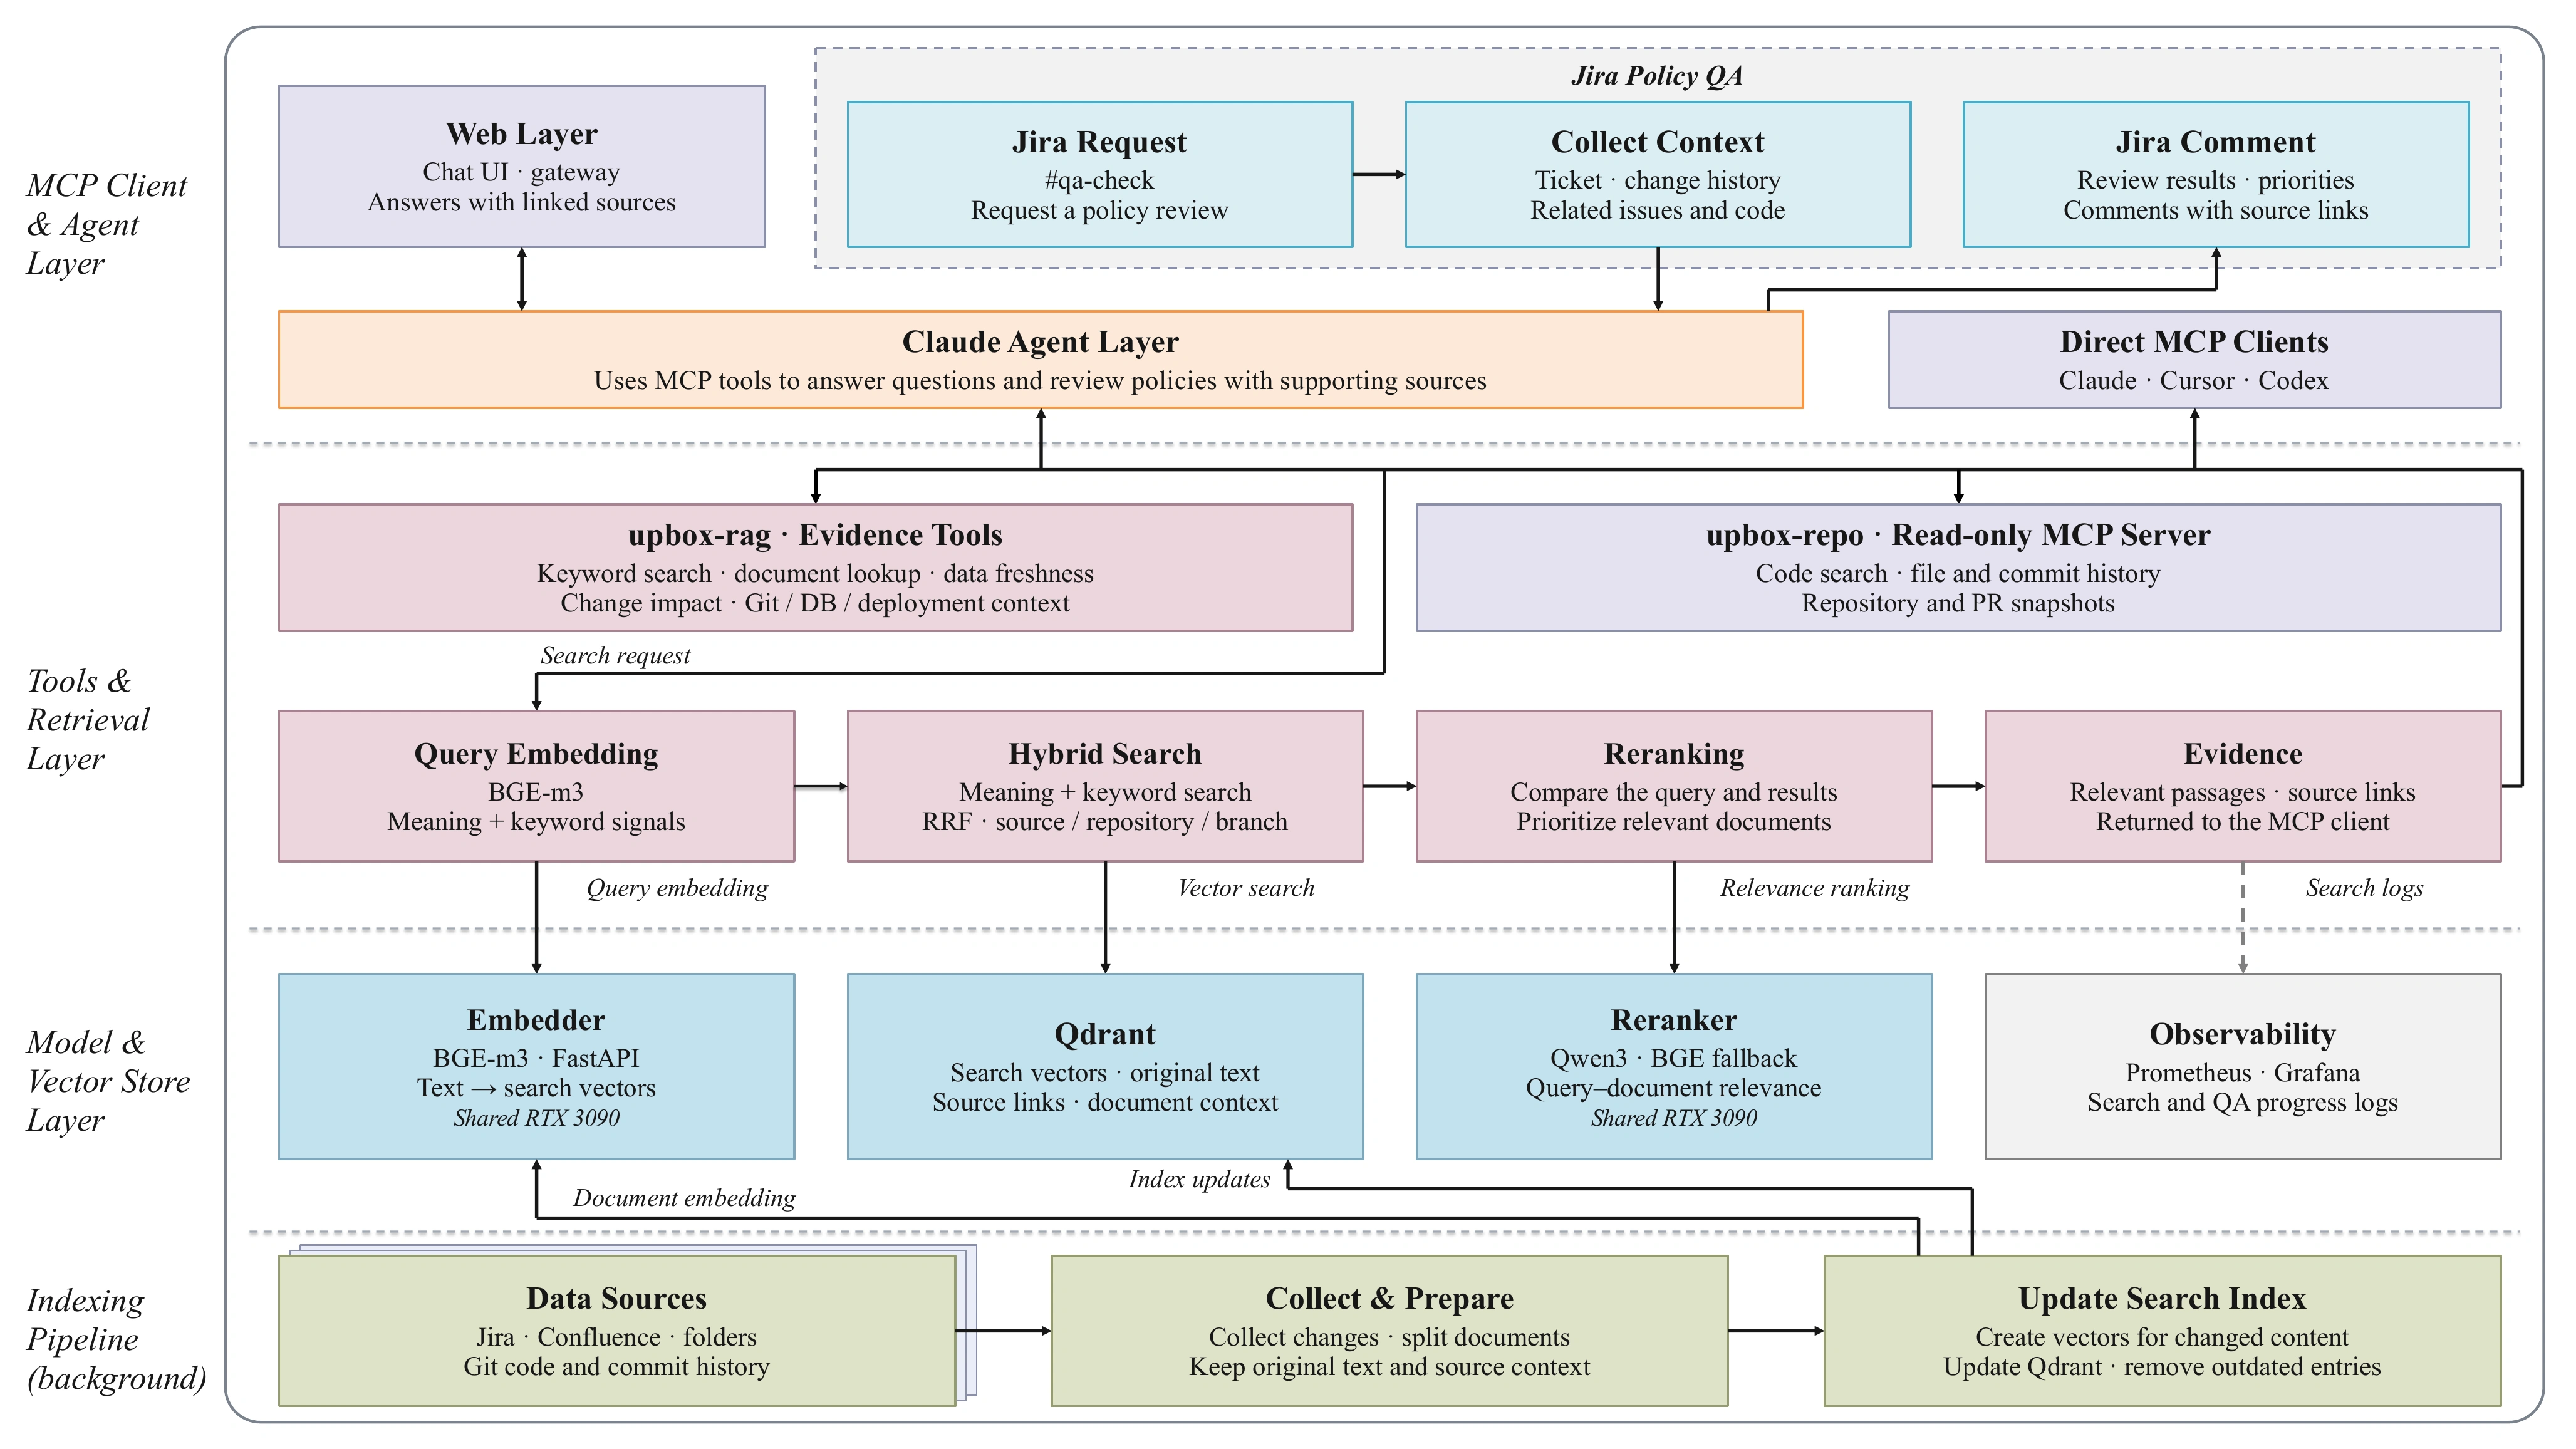
Jira와 Confluence, Git에 흩어진 정책과 코드를 에이전트가 직접 검색하도록 MCP 기반 Agentic RAG 플랫폼을 구축했습니다. 업무마다 관련 자료를 찾아 맥락을 전달하던 과정을 줄이고, QA 준비와 개발 지원에서 기획 티켓의 정책 검토까지 연결했습니다.
- Role
- 사내 RAG 플랫폼 단독 설계, 개발, 운영 (검색, MCP 서버, 정책 검토 기능, 모니터링)
- Stack
- Go, Python, BGE-M3, Qdrant, MCP, Claude Code, Prometheus, Grafana
- Outcome
- 사내 지식 검색 플랫폼 구축, QA와 개발 업무에 도입, Jira 정책 검토 자동화
문제 정의
같은 기능을 이해하기 위해 매번 다시 찾던 근거
기능의 요구사항과 논의는 Jira에, 배경과 정책은 Confluence에, 실제 구현과 변경 이력은 Git에 있었습니다. 각 도구에서 자료를 찾은 뒤에도 티켓에서 바뀐 결정이 정책 문서와 코드에 반영됐는지 직접 대조해야 했습니다. AI 개발 도구를 쓸 때도 필요한 자료를 찾아 복사하고 맥락을 다시 설명하는 일이 반복됐습니다.
QA에서도 자료를 찾고 연결하는 일이 남아 있었습니다. E2E로 기본 기능의 반복 검수는 줄였지만, 신규 기능과 변경 기능은 요구사항을 읽고 영향 범위를 찾아 테스트 케이스(TC)를 구성해야 했습니다. 과거 버그와 다른 기능의 예외까지 고려하려면 다시 여러 도구를 오가야 했고, 검증 범위는 담당자가 기억하는 내용에 영향을 받았습니다.
이 과정을 줄이기 위해 흩어진 사내 지식을 함께 검색하고 대조할 수 있는 RAG 플랫폼을 구축했습니다. 먼저 QA 준비와 검증에 적용하고, 개발자의 구현 지원과 기획 단계의 정책 검토로 활용을 넓혔습니다.
검색 설계
비슷한 주제에서 필요한 조건을 찾는 검색으로
먼저 Jira와 Confluence, Git의 자료와 검증 기록을 수집해 색인했습니다. 검색은 질문과 문서를 벡터로 바꾸고 의미가 가까운 내용을 찾는 dense 검색으로 시작했습니다. 문서의 정확한 용어를 몰라도 자료를 찾을 수 있게 하려는 선택이었습니다. 예를 들어 "수거를 잠시 멈추고 싶다"는 질문으로 "임시중단 예약" 정책을 찾는 식입니다.
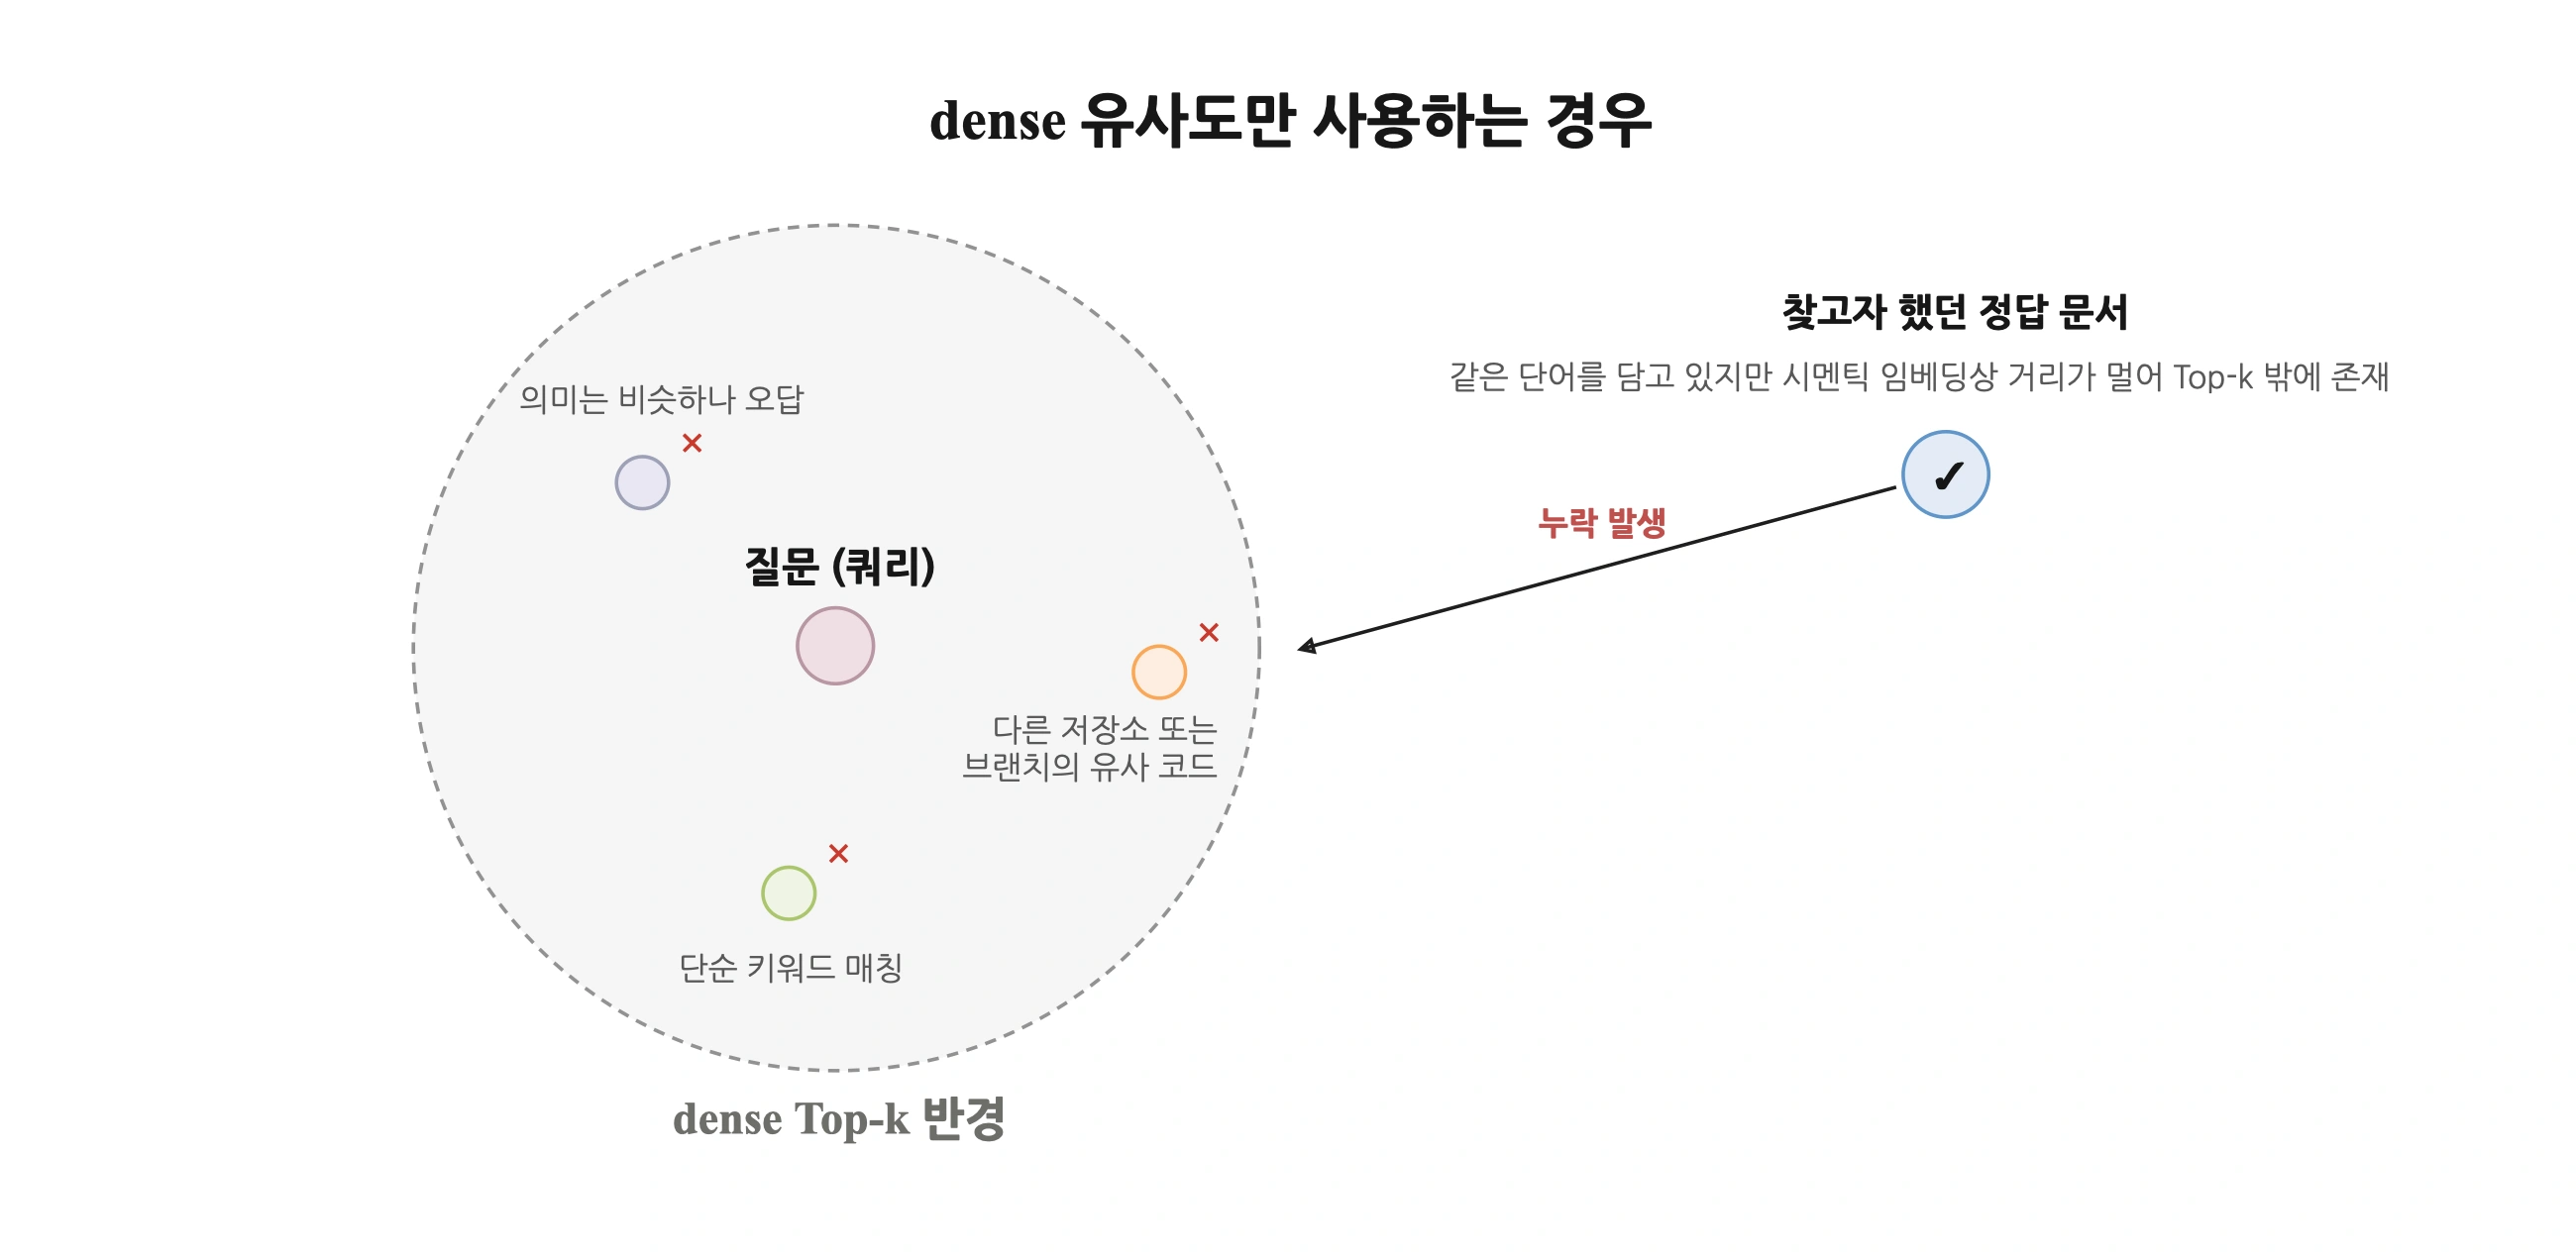
하지만 주제가 비슷하다고 질문에 답할 수 있는 것은 아니었습니다. "재계약 시 작업량 이관 조건"을 찾을 때는 계약을 복사하는 일반 절차보다 이관할 수 있는 조건과 제한이 필요합니다. 의미 유사도만으로 순위를 정하면 같은 재계약 주제의 다른 문서가 앞서고, 필요한 조건은 상위 후보(Top-k) 밖으로 밀릴 수 있었습니다. QA에 쓸 근거라면 이 차이를 놓쳐서는 안 됐습니다.
그래서 dense 검색에 실제 등장하는 용어를 비교하는 sparse 검색을 더했습니다. BGE-M3에서 두 벡터를 함께 생성하고 각각 검색한 뒤, Qdrant의 RRF로 순위를 합쳤습니다. 점수의 크기와 분포가 다른 두 검색을 단순 합산하는 대신 각 검색에서 얼마나 상위에 나왔는지로 결합했습니다. 표현이 다른 질문은 dense가, "작업량", "이관"처럼 구체적인 용어가 중요한 질문은 sparse가 보완하도록 했습니다.
같은 단어가 있어도 필요한 조건까지 설명하는 문서는 아닐 수 있습니다. 합쳐진 후보는 cross-encoder가 질문과 함께 읽고 관련성을 다시 평가하도록 했습니다. 후보에 들어오지 않은 문서는 리랭킹으로도 찾을 수 없으므로, 두 검색으로 누락을 줄인 뒤 순위를 다듬는 순서입니다. 연산 부담이 큰 비교는 먼저 추린 후보에만 적용했습니다.
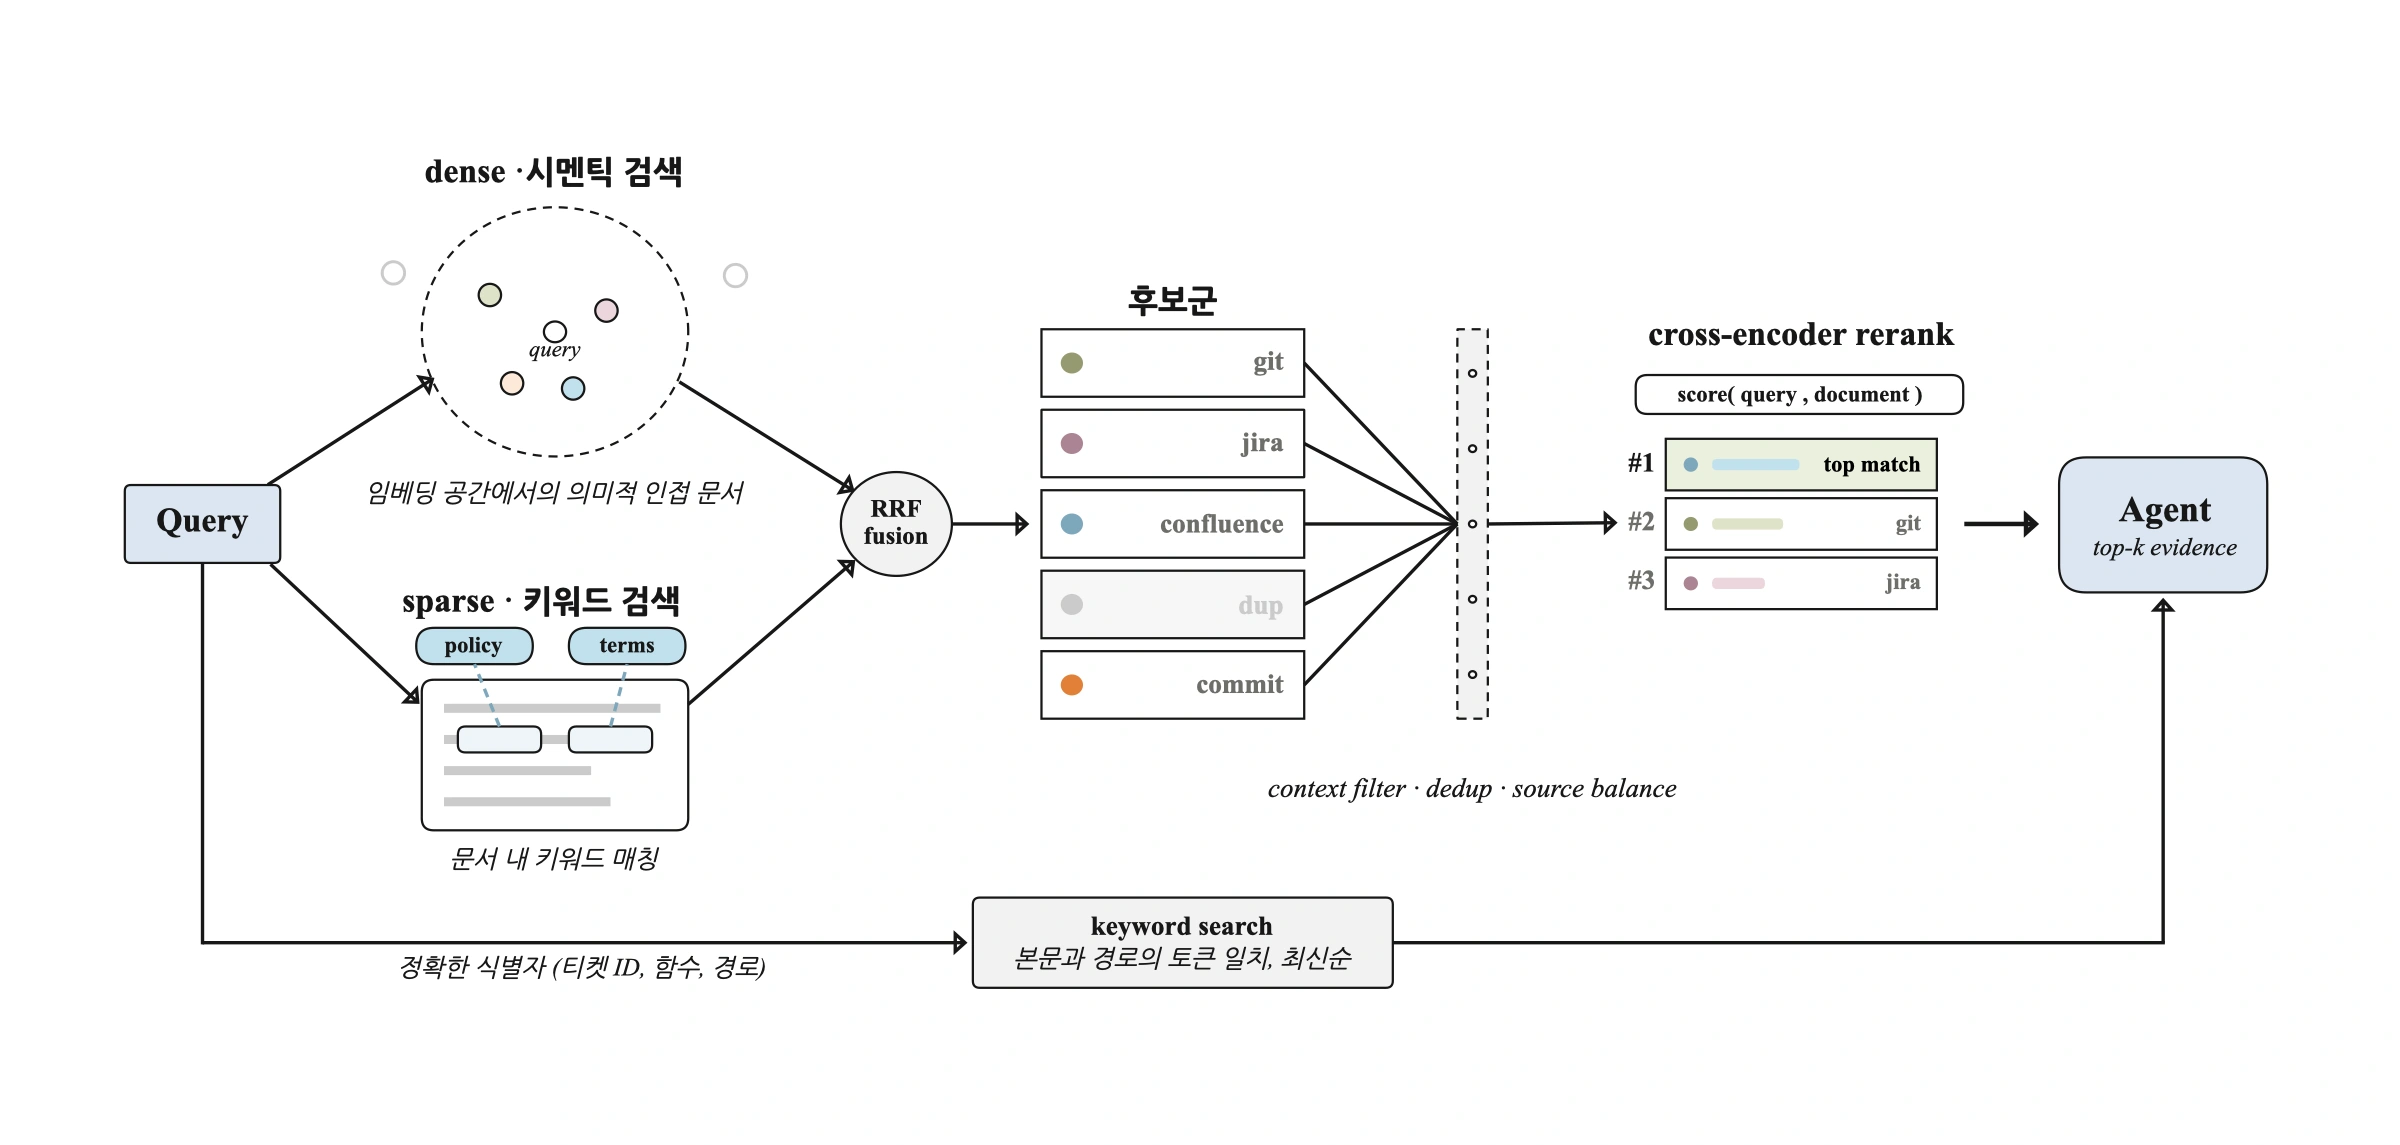
검색 대상의 맥락도 제한했습니다. 다른 저장소나 개발 중인 브랜치의 코드를 현재 기능의 근거로 오해하지 않도록 후보 검색에 저장소, 경로, 브랜치 조건을 적용했습니다. 티켓 번호나 함수명처럼 대상을 이미 아는 조회는 임베딩과 리랭킹을 거치지 않는 별도 키워드 검색으로 분리했습니다.
한 문서의 비슷한 문단이 상위를 채우면 함께 봐야 할 정책과 코드가 밀릴 수 있었습니다. 문서별 결과 수를 제한하고 소스별 후보를 확보해, 여러 자료를 대조해야 하는 질문에 한 종류의 자료만 남지 않도록 했습니다.
아래 3D 분포는 dense와 sparse가 같은 자료를 다르게 표현하는 방식을 보여 줍니다. hybrid는 dense와 차원을 줄인 sparse를 각각 정규화해 연결한 시각화용 근사입니다. 실제 검색은 두 결과의 순위를 RRF로 합치며, 그림 속 거리나 배치가 검색 정확도를 뜻하지는 않습니다.
전통 RAG 구조의 한계
검색과 생성을 연결한 뒤 드러난 한계
이 검색 기반에 Qwen3.5 모델을 연결해, 찾은 자료를 근거로 답변을 생성하도록 구성했습니다. 구축한 RAG를 테스트하는 과정에서 몇 가지 한계를 확인했습니다.
먼저, 답변의 품질이 처음 확보한 검색 결과에 크게 좌우됐습니다. 관련 문서를 찾았더라도 질문에 필요한 조건과 예외까지 충분히 포함됐는지는 별도로 판단해야 했습니다. 근거가 부족하거나 서로 다른 설명이 섞여 있을 때는, 검색어를 바꾸고 다른 자료를 찾아 보완하는 과정이 필요했습니다.
여러 자료를 종합해야 하는 질문에서도 한계가 드러났습니다. 질문을 세부 항목으로 나눠 각각의 근거를 찾고, 앞서 확인한 내용에 따라 다음 검색 대상을 바꿔야 했습니다. 검색과 생성을 미리 정한 순서로 연결하는 구조에서는 이러한 판단과 재탐색을 별도로 설계해야 했습니다.
검색량을 늘려 많은 자료를 한꺼번에 전달하는 방법에도 한계가 있었습니다. 불필요하거나 중복된 내용이 늘면 필요한 근거를 선별하기 어려워지고, 처리 부담도 커졌습니다. 더군다나 검색 결과의 해석과 답변 품질을 높이고자 더 큰 모델을 직접 운영하기에는, 가용 인프라와 운영 비용의 제약도 있었습니다.
Agentic RAG 설계
에이전트가 업무에 필요한 맥락을 직접 찾도록
이러한 한계를 줄이기 위해 질문을 나누고, 검색한 근거를 평가하며, 부족한 정보를 다시 찾아가는 과정을 포함하는 Agentic RAG로 전환했습니다.
기존 Retriever의 검색 기능을 MCP 도구로 제공하고, 근거를 해석해 답변을 구성하는 Generator 역할은 Claude 에이전트에 맡겼습니다. 문서 검색과 코드 조회를 같은 에이전트의 도구로 연결해, 한 자료에서 발견한 단서를 다른 자료의 조회로 이어가도록 했습니다. 도구 선택과 대화 맥락 관리는 Claude Code의 실행 환경을 활용하고, 사내 인프라는 지식 수집과 색인, 검색을 담당하도록 역할을 나눴습니다.
업무 적용
QA 준비부터 실제 검증까지
검색한 자료는 먼저 QA에 활용했습니다. Codex와 Claude에 RAG를 MCP로 연결해, 요구사항과 이전 버그, 코드, 검증 기록을 함께 조회하도록 했습니다. 이를 바탕으로 역할과 상태에 따른 동작, 경계값과 예외, 인접 기능의 회귀 범위를 테스트 케이스(TC)로 구성했습니다.
에이전트와 함께 테스트 케이스와 필요한 데이터를 빠르게 생성하고, 실제 브라우저에서 업무 흐름을 실행한 뒤 API로 저장 결과와 상태를 확인했습니다. 여러 조건과 데이터 조합을 검증하면서 수기 검수에서 미처 발견하지 못했던 버그를 추가로 찾았고, 테스트할 수 있는 시나리오의 폭도 넓혔습니다.
반복되는 기본 기능은 E2E로 검증하고, 신규 기능과 변경 기능의 정책 및 예외는 에이전트가 찾은 근거와 실행 결과를 바탕으로 제가 최종 판단했습니다. 재검증에도 이전 재현 조건과 수정 의도를 활용했습니다.
기본 기능의 자동 실행과 PR별 검증 환경은 E2E QA Automation에서 이어집니다.
확장 #1
내부 평가를 거쳐 개발자의 도구로
QA에서 활용한 지식을 개발 중에도 참고할 수 있도록, 함수의 사용처와 의존 관계, 코드 변경의 영향 범위를 확인하는 기능을 추가했습니다. 현재 코드를 읽고 수정 계획을 세운 뒤, 관련 요구사항과 과거 버그, 다른 저장소의 사용처를 대조할 수 있도록 했습니다.
개발에 적용하기 전에는 실제 배포된 백엔드 티켓을 재구성해 내부 A/B 평가를 진행했습니다. 기본 환경과 RAG, 공통 에이전트 작업 지침, 정적 코드 구조 조회 도구 5개를 함께 적용한 환경을 비교했습니다. 개발 구현 정확도는 Opus 79.5점 → 84.8점, Sonnet 78.2점 → 82.6점으로 각각 6.67%, 5.63% 개선됐습니다.
Opus
Sonnet
수정 전 코드와 당시 참조할 수 있었던 지식을 기준으로, 두 모델이 격리된 환경에서 같은 티켓을 구현하도록 했습니다. 결과물은 독립된 Opus 평가 에이전트 3개가 요구사항 충족, 관련 기능과 예외 처리, 과거 후속 버그 예방, 불필요한 변경, 과도한 설계에 따른 회귀 위험의 다섯 기준으로 평가했습니다. 출력 토큰은 Opus 약 1.22배, Sonnet 약 1.16배로 늘어, 구현 정확도와 함께 생성량의 변화도 확인했습니다.
개선 효과를 확인한 뒤에는 MCP 연결 설정과 공통 에이전트 작업 지침을 개발자에게 함께 공유했습니다. 지침에는 사내 정책과 변경 이력을 언제 검색하고, 찾은 근거를 코드 수정과 검증에 어떻게 반영할지 정리했습니다. 개발자가 사용하던 Claude, Cursor, Codex에서 같은 지식을 활용하도록 적용했습니다.
확장 #2
구현 전에 기획의 빠진 조건부터 확인
개발자가 요구사항대로 구현하더라도, 기획 자체에 빠진 조건이나 모순이 있으면 버그로 이어질 수 있었습니다. 그래서 구현보다 앞선 Jira 기획 티켓의 정책 검토로 활용을 넓혔습니다. 기획자가 Jira 댓글에 #qa-check를 남기면 워커가 검토를 진행하고 같은 티켓에 결과를 게시하도록 했습니다.
본문만 읽고 논의 중 바뀐 결정을 놓치지 않도록 댓글과 필드 변경 이력, 직접 연결된 티켓도 수집했습니다. PR 링크가 있으면 동기화된 PR head 코드까지 대조하고, 확인하지 못한 코드와 기준 브랜치는 미확인으로 남겼습니다.
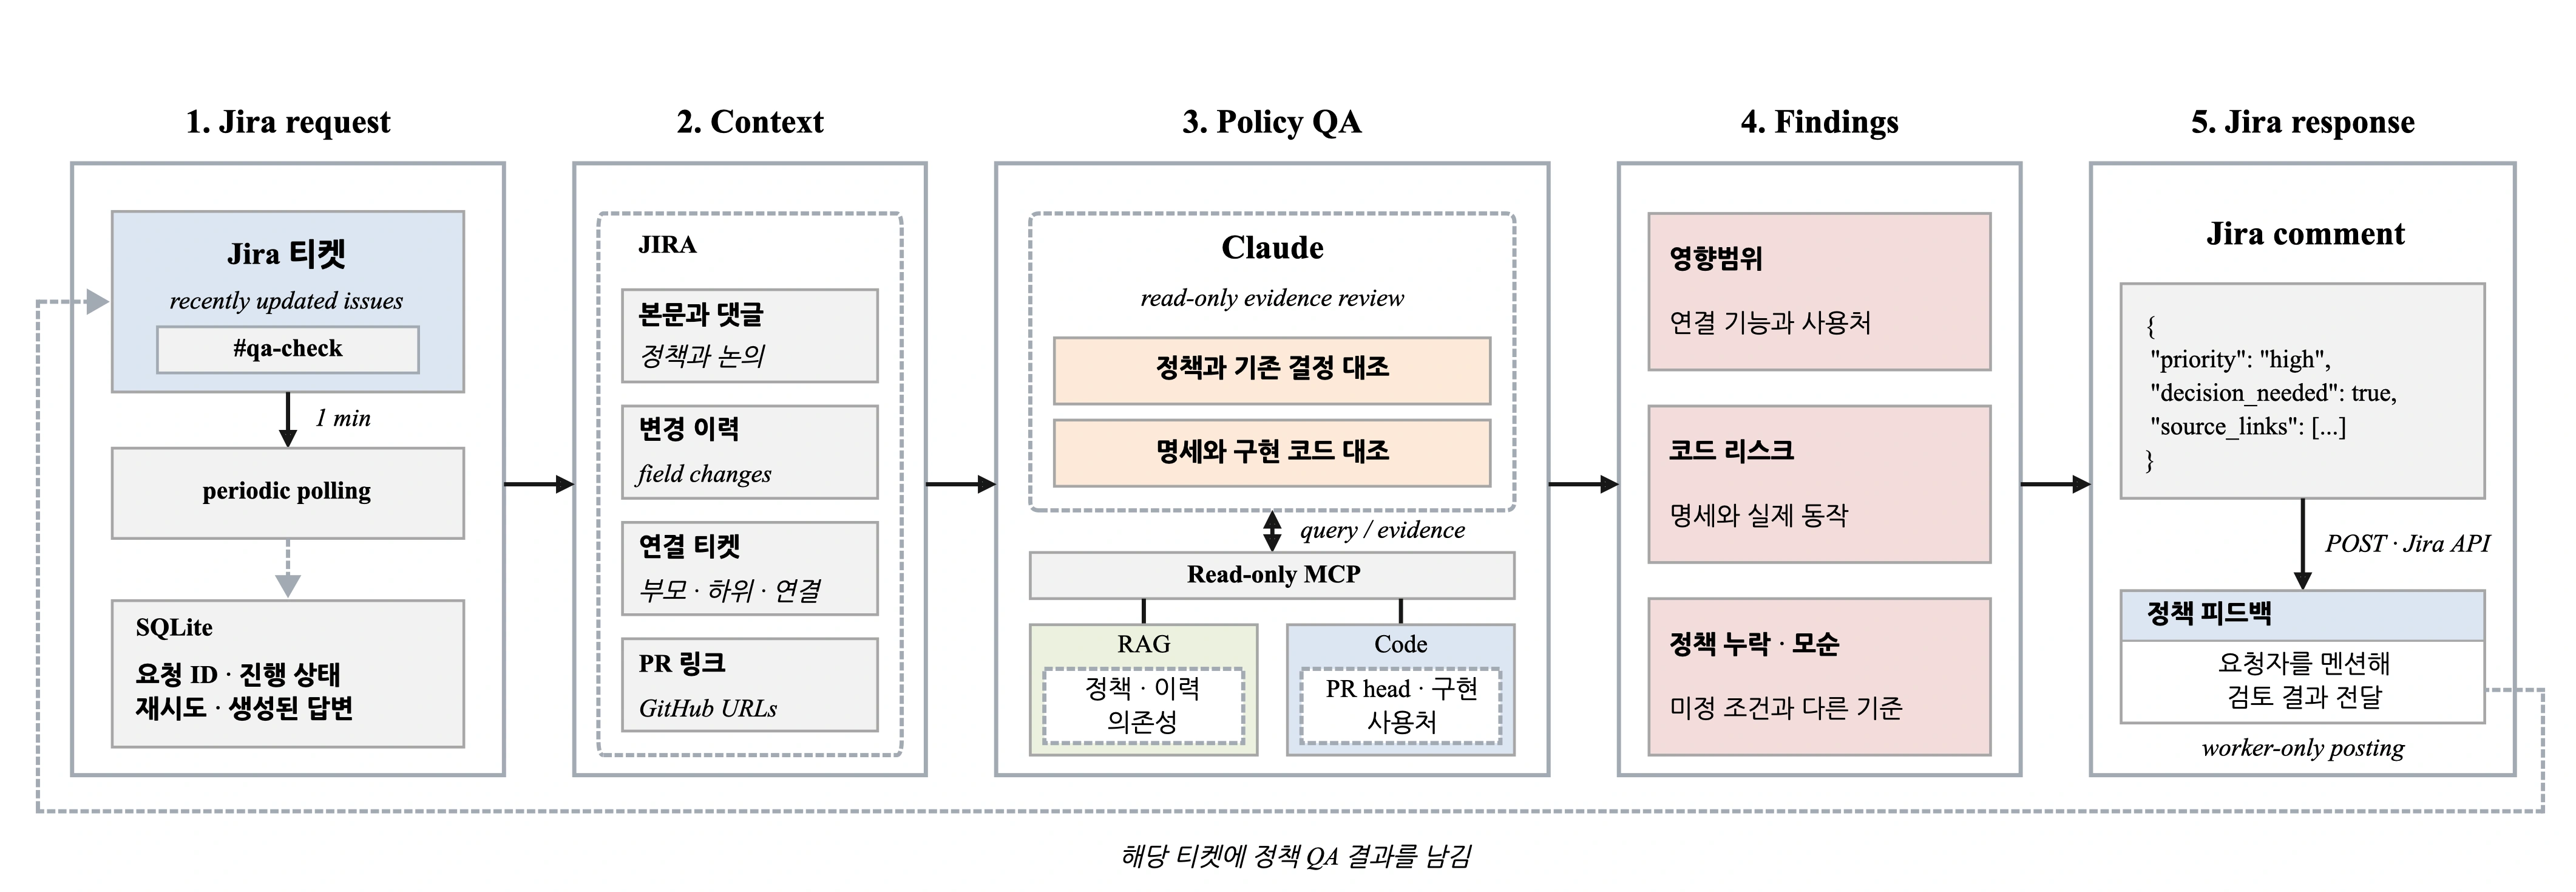
코드는 근거로 활용하되 결과는 기획자가 결정할 수 있는 내용으로 정리했습니다. "어느 함수를 고쳐야 한다"보다 "어떤 조건의 정책이 빠졌고, 무엇을 정해야 하는지"를 우선순위와 출처 링크로 전달했습니다. 기획자가 이를 바탕으로 정책을 보강하도록 한 것입니다.
검토 모델에는 읽기 전용 도구만 제공하고 Jira 댓글 게시 권한은 워커에만 두었습니다. 결과는 요청 댓글의 공개 범위를 유지하며, 요청 ID와 진행 상태를 SQLite에 저장해 재시작이나 재시도 때 같은 결과가 중복 게시되지 않도록 했습니다.
확장 #3
업무 화면에서 바로 묻는 사내 지식
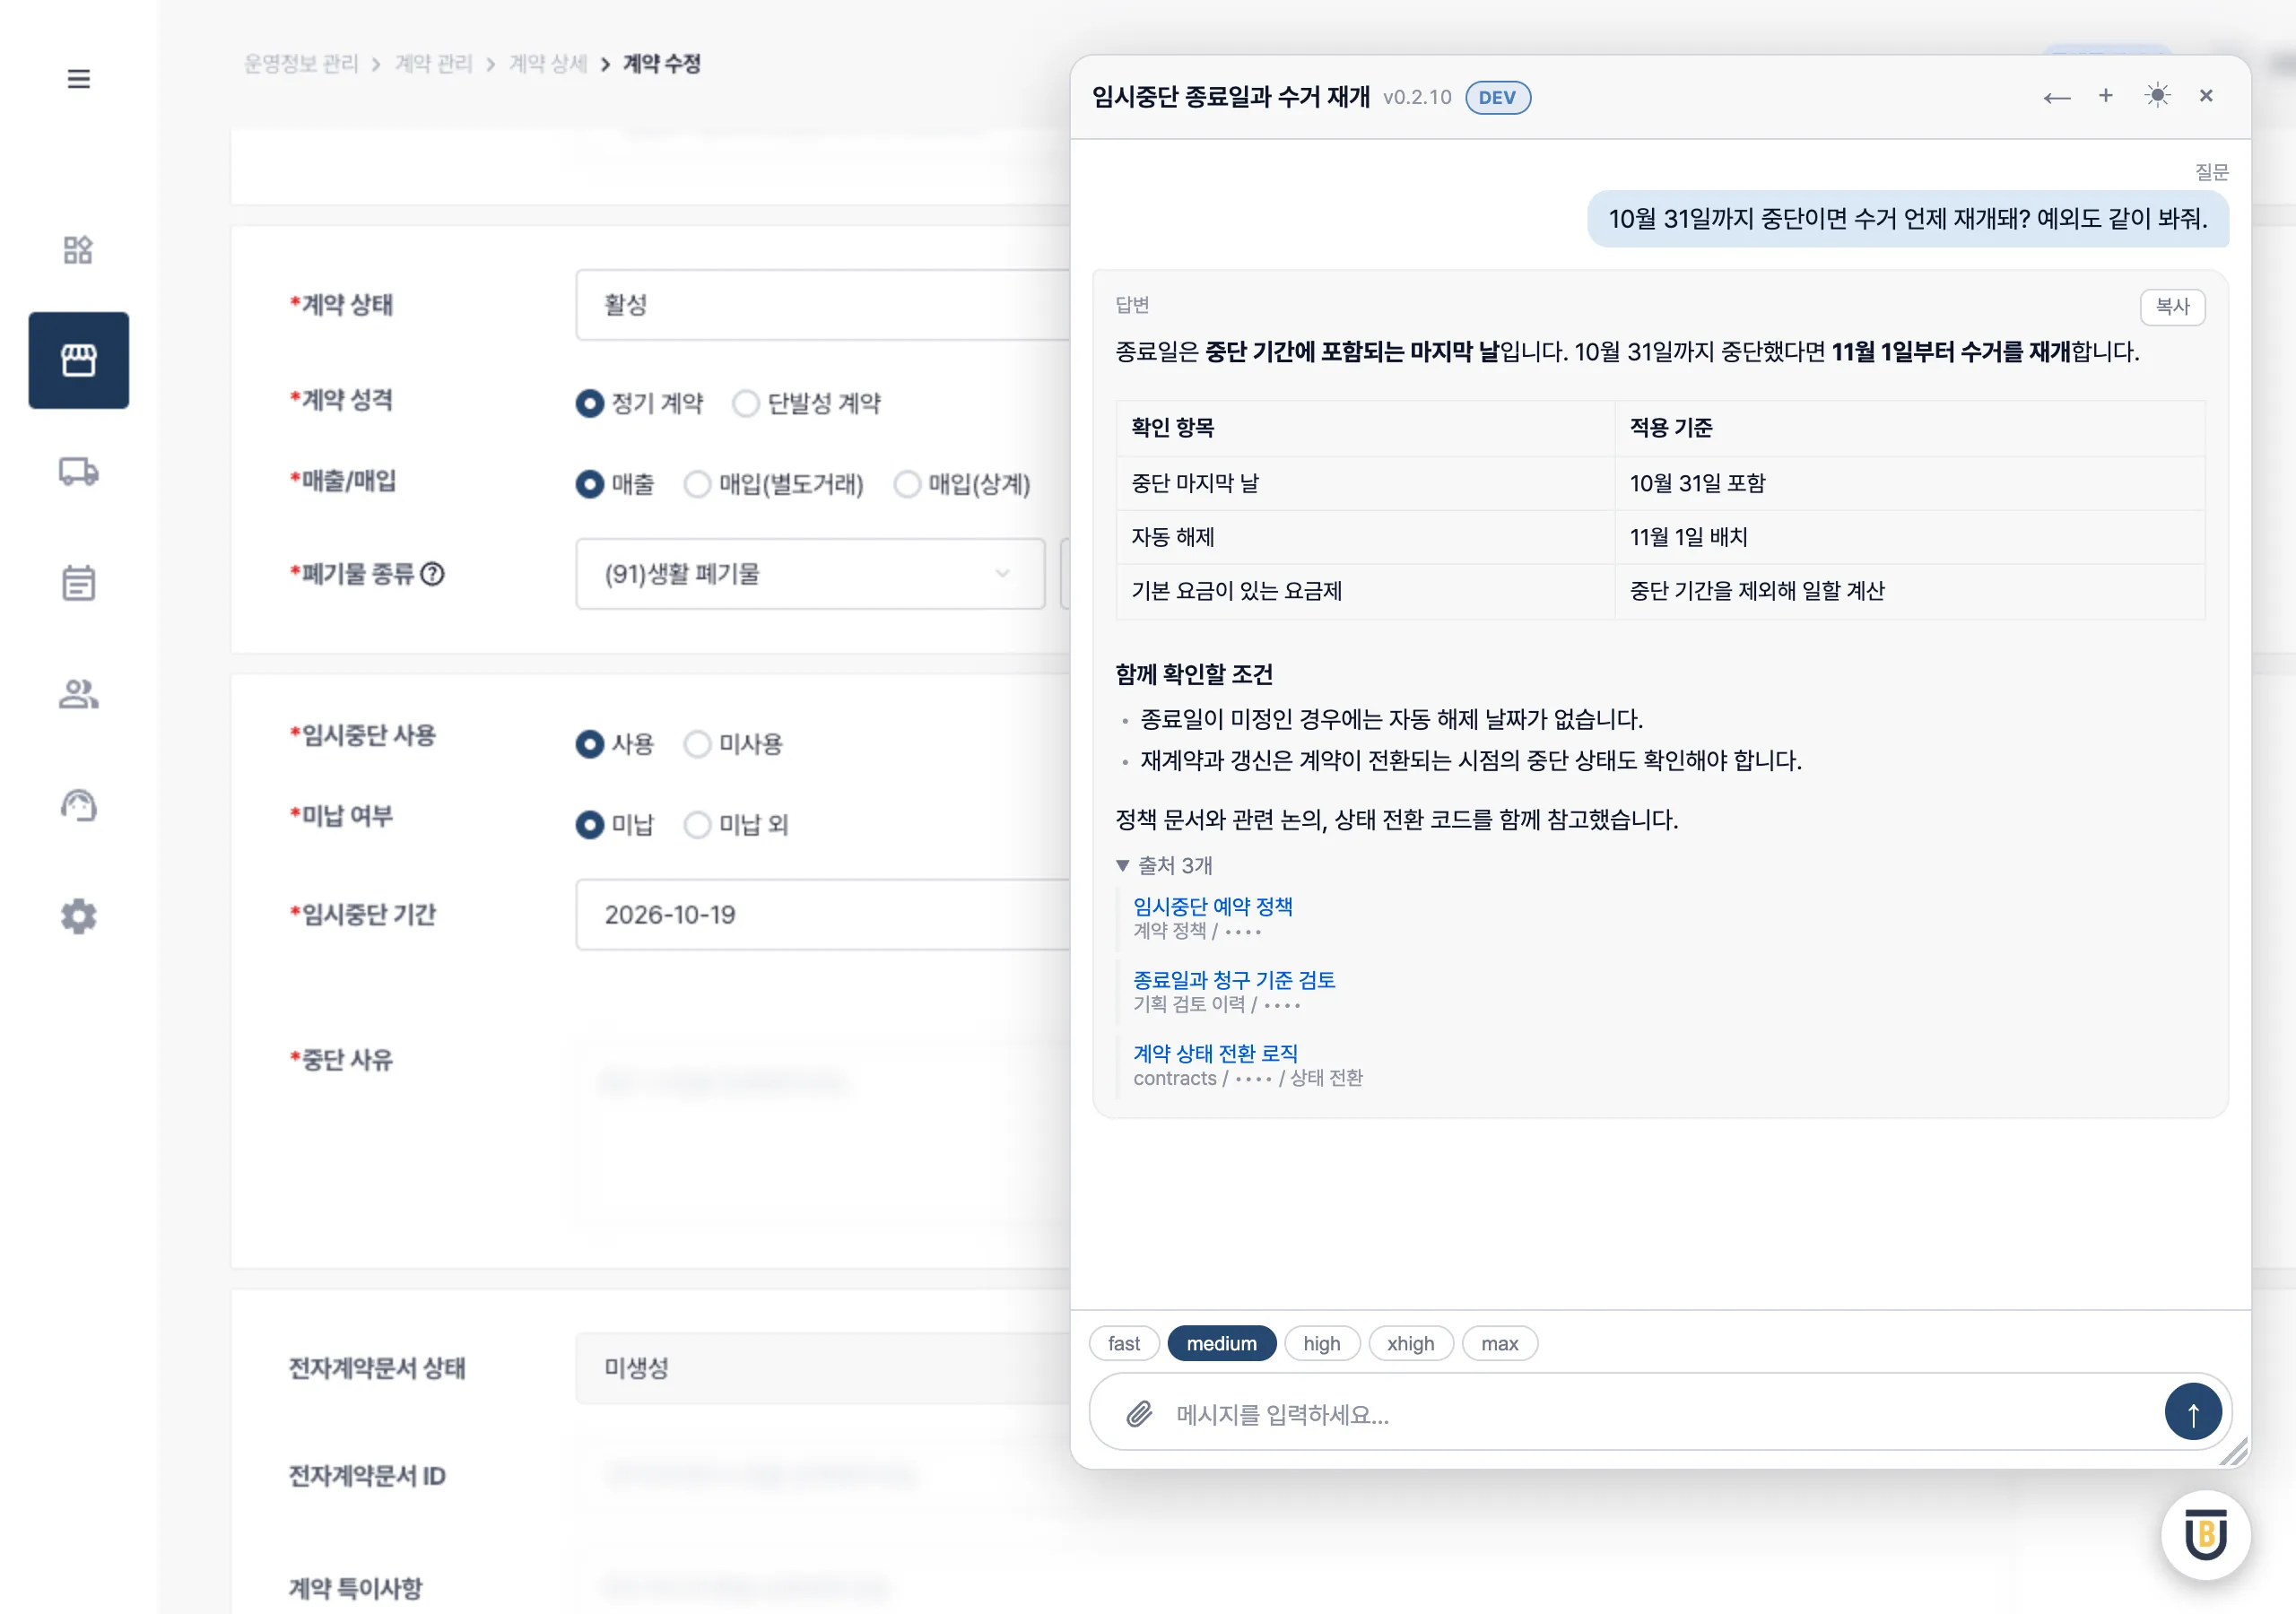
MCP를 직접 설정하지 않고도 사내 지식에 질문할 수 있도록 웹 UI와 Chrome 확장 프로그램을 구축했습니다. 웹에서는 질문과 대화 이력을 관리하고, 확장 프로그램에서는 보고 있던 업무 페이지 위에 질문창을 열어 답변과 출처를 확인할 수 있도록 했습니다.
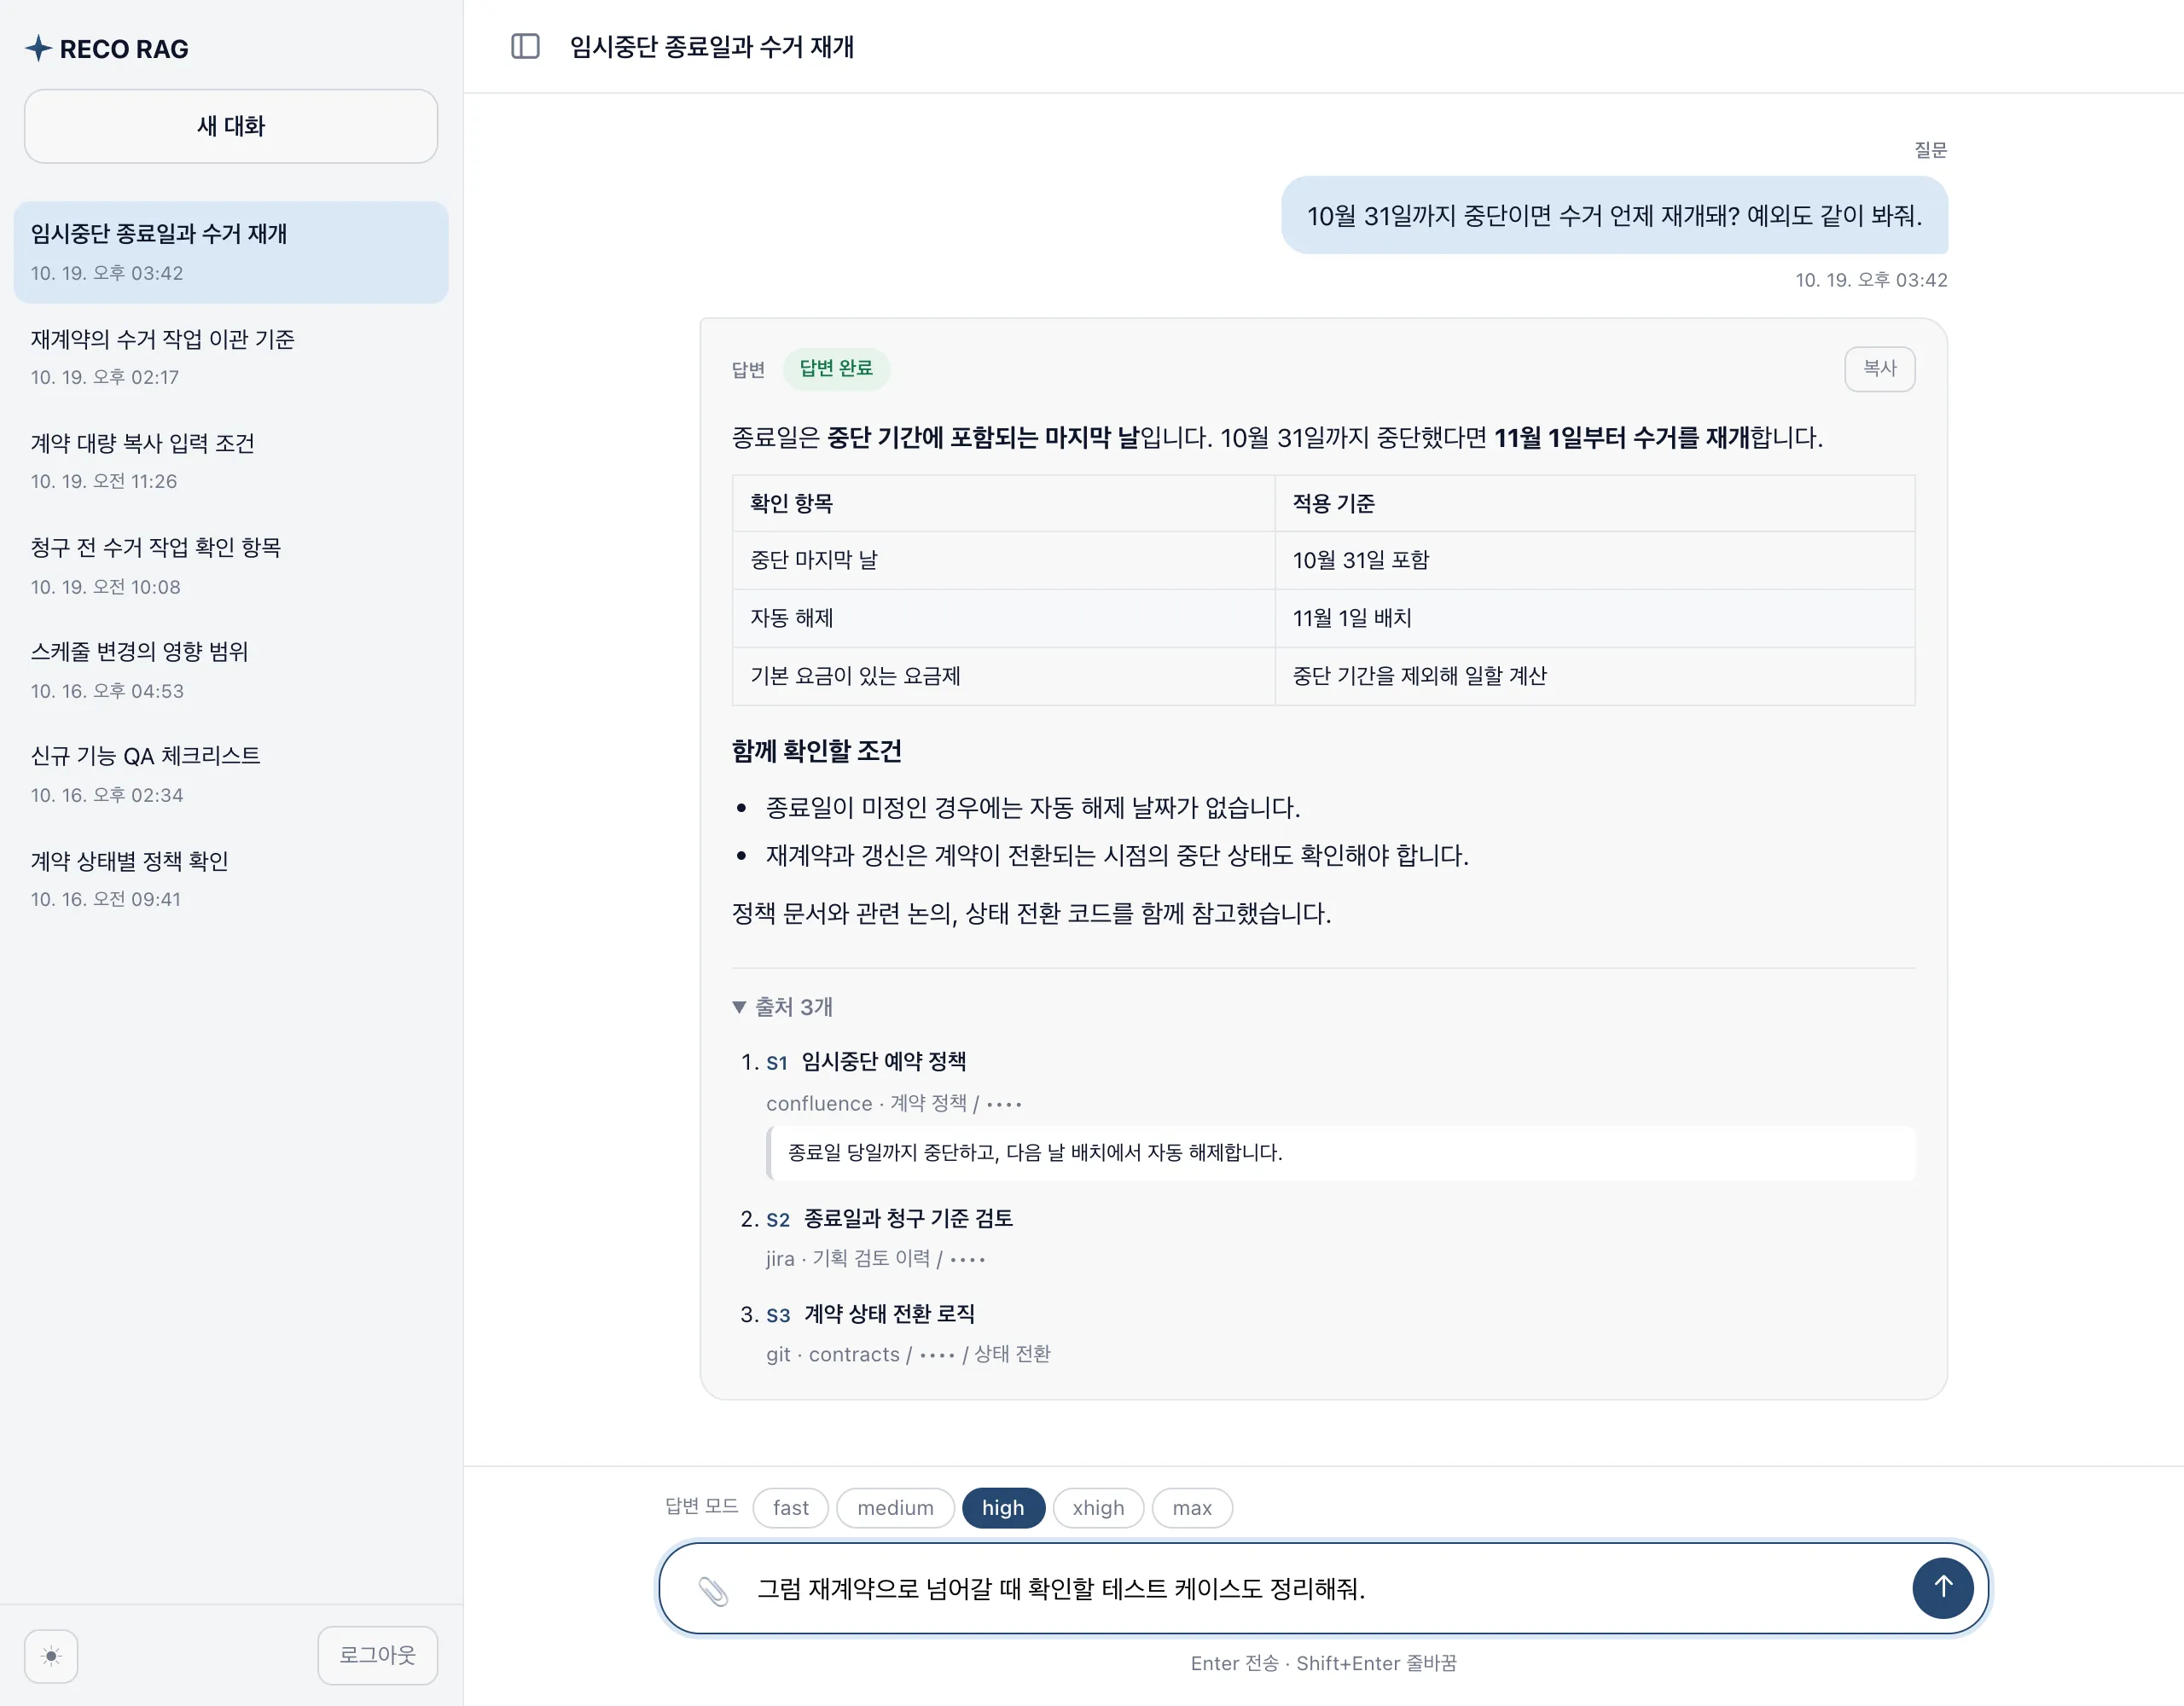
웹과 확장 프로그램은 같은 답변 계층에 연결했습니다. Claude 에이전트가 필요한 문서와 코드를 조회하는 기반을 함께 활용하면서, 사내 지식에 접근하는 경로를 개발 도구에서 일상적인 업무 화면까지 넓혔습니다.
운영 모니터링과 대응
RAG의 지식 갱신과 서비스 상태를 함께 모니터링
QA와 개발, 기획에서 같은 지식을 활용하자 "찾은 코드가 지금 테스트 환경에도 배포돼 있나?"까지 확인할 필요가 생겼습니다. 코드와 커밋 조회만으로는 알 수 없어, 배포 버전과 DB 변경 이력을 별도의 읽기 전용 도구로 확인하도록 연결했습니다.
검색 자료의 갱신 시점도 구분했습니다. 검색 서버와 주기적인 색인 작업을 분리하고 문서 ID를 유지해 변경분을 동기화했습니다. 소스별 갱신 상태와 기본 브랜치, 미병합 개발 브랜치를 구분해 오래된 자료나 진행 중인 구현을 현재 상태로 오해하지 않도록 했습니다.
응답이 느려졌을 때는 검색 처리와 자원 상태를 함께 볼 수 있어야 했습니다. Go 검색 서버와 Jira 워커의 지표를 Prometheus로 수집하고 Grafana 대시보드를 구성했습니다. 도구별 요청량과 p50, p95 응답 시간을 RSS, Go Heap, Goroutine, 열린 파일 수 및 CPU, 메모리, GPU 사용량과 대조하도록 했습니다. 색인 완료 시점과 브랜치 갱신 상태도 별도로 표시했습니다.
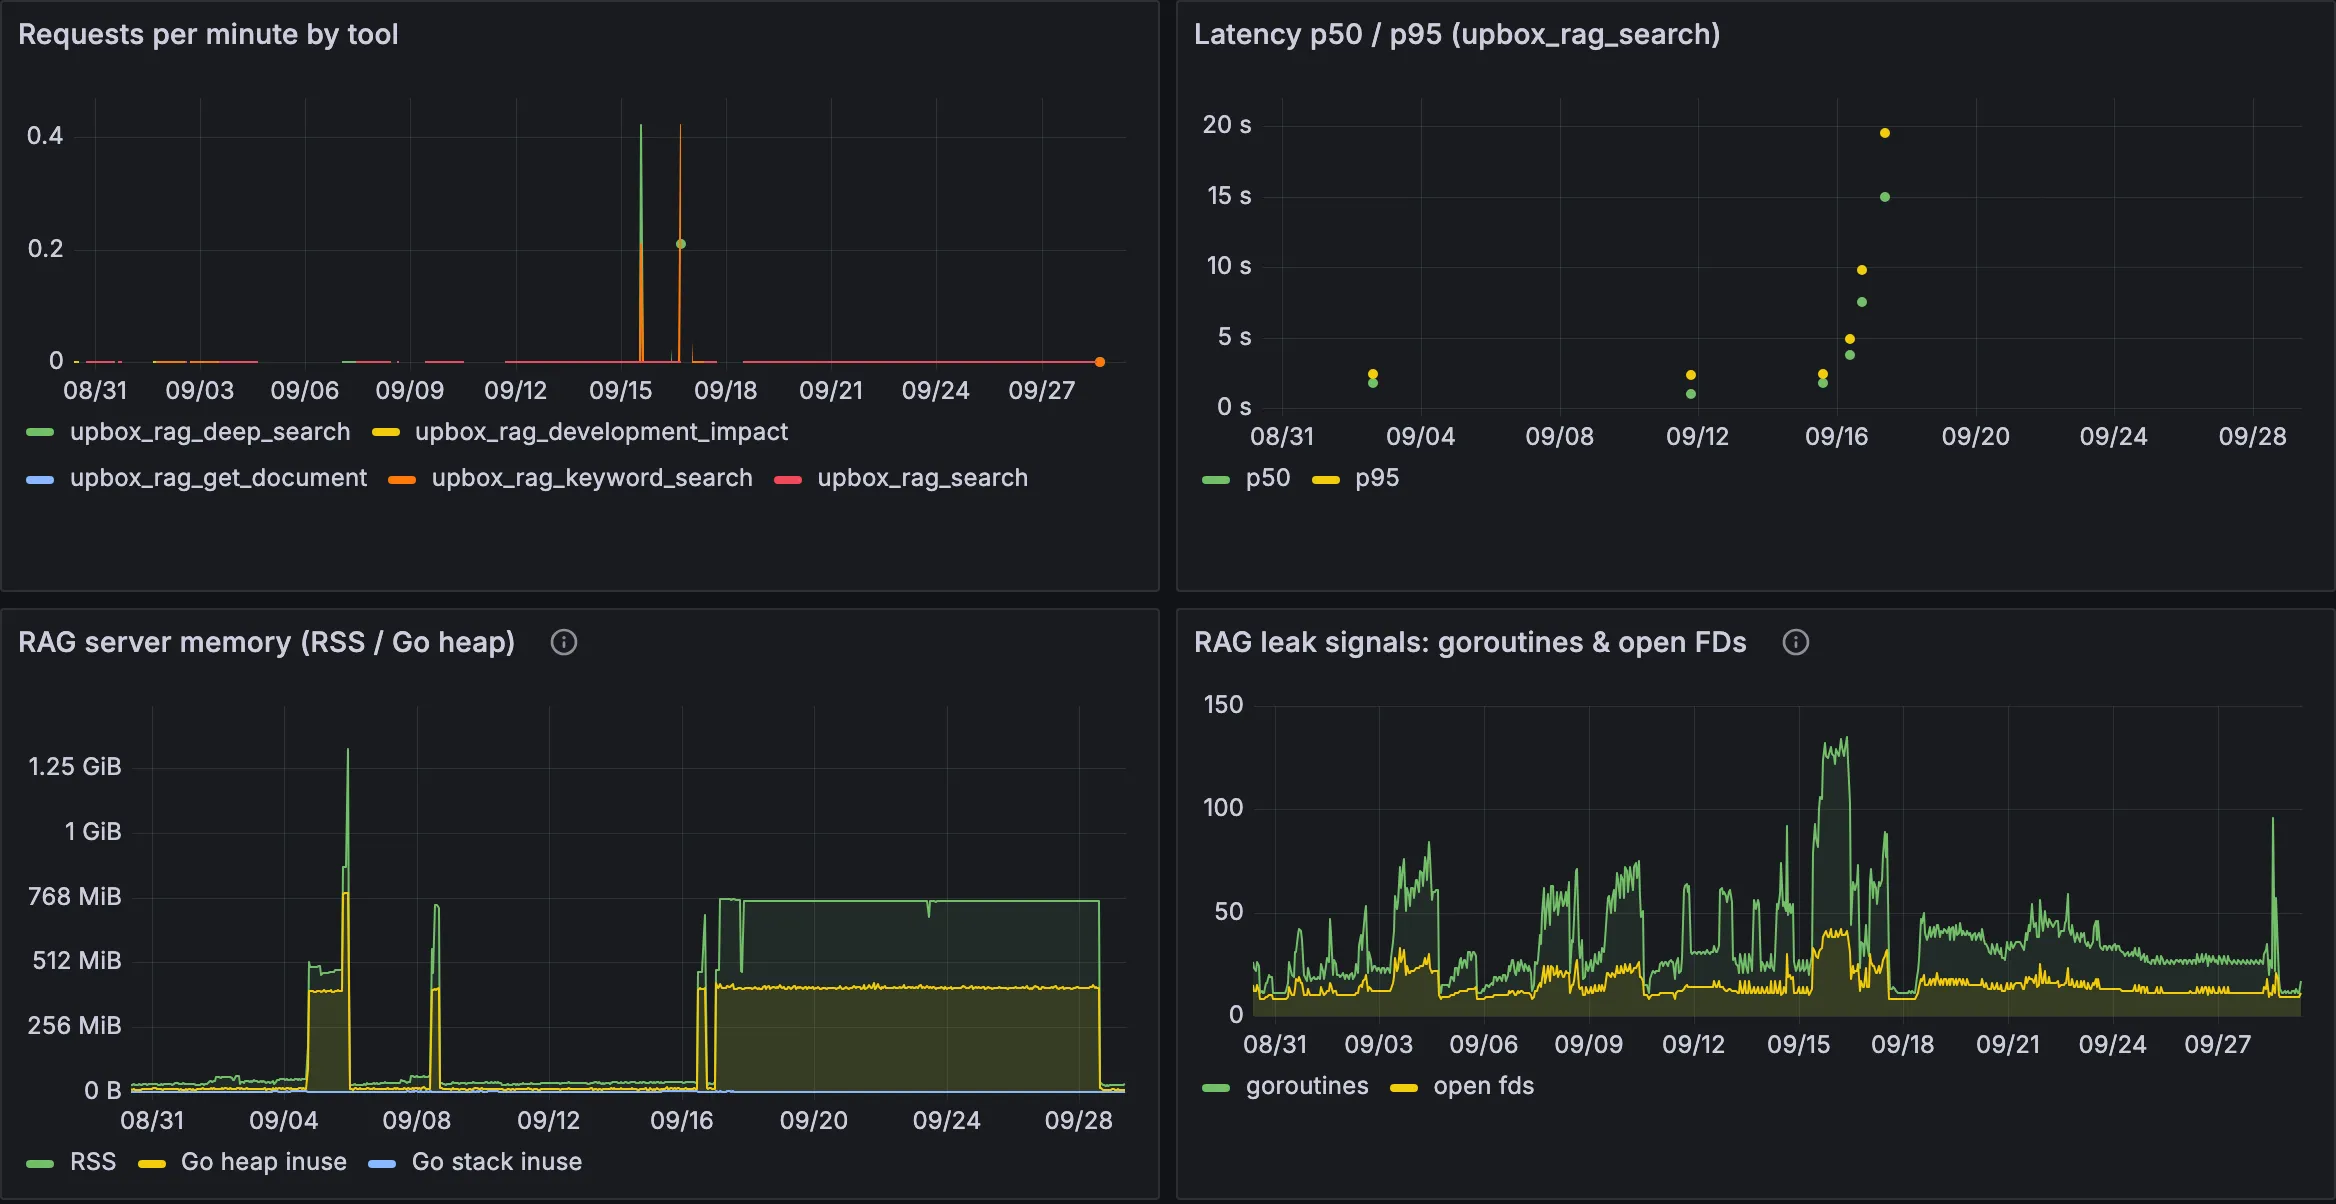
임베더와 리랭커가 GPU 한 장을 함께 사용할 때는 공유 락으로 경합을 조정했습니다. 리랭커가 실패하더라도 대체 모델이나 검색 결합 순위로 응답하도록 해, 정밀 순위 평가의 실패가 전체 검색 실패로 이어지지 않게 했습니다.
Jira 검토는 워커가 실행 중이라는 사실만으로 진행 여부를 알 수 없었습니다. 마지막 티켓 수집 시각과 진행 중인 검토, 작업 heartbeat, Claude 응답 활동을 나눠 요청 수집 실패와 검토 정체를 구분했습니다. 수집과 검토 실행을 분리하고 실패한 작업은 최초 실행을 포함해 최대 5회만 시도하도록 했습니다.
관측한 지표가 실제 대응으로 이어지도록 런북도 정리했습니다. 검색 지연과 오류율, 색인 갱신 상태, Jira 워커의 동작 상태를 주요 지표(SLI)로 삼고 평소 관측값과 타임아웃, 폴링 주기, 재시도 설정을 바탕으로 확인 기준과 대응 순서를 작성했습니다.
| 지표 (SLI) | 확인 항목과 기준 | 대응 절차 |
|---|---|---|
| 검색 지연 | p95 응답 시간, 리랭커 타임아웃 30초, HTTP 타임아웃 60초 | RSS, Go Heap, Goroutine과 GPU 경합 확인 → 리랭커 오류 시 검색 결합 순위로 응답하는지 점검 |
| 검색 오류율 | 도구별 오류 수(rag_errors_total), 백엔드 상태(rag_backend_up == 0)가 5분간 지속 | 오류가 발생한 도구 확인 → embedder와 Qdrant 상태 점검 → 오류 로그와 대체 응답 경로 확인 |
| 색인 갱신 상태 | 이벤트 처리 lease 300초, 상태 재확인 주기 1분, 브랜치 동기화 주기 30분, 색인 상태(error/pending) | 소스별 색인 체크포인트와 브랜치 갱신 상태 확인 → 5회 시도 후에도 실패한 작업(dead-letter) 점검 |
| Jira 티켓 수집 | 마지막 티켓 수집 성공 이후 3분 초과(critical) | 워커 실행 상태와 마지막 수집 성공 시각 확인 → 워커 재시작 |
| Jira 검토 상태 | 작업 heartbeat 미갱신 1분 초과(critical), Claude 무응답 10분 초과(warning) | 검토 진행 단계와 작업 lease(45분) 확인 → 멈춘 검토 작업 재시도 |
| 재시도 한도 도달 | 총 5회 시도 실패 시 exhausted로 분류, 재시도 대기 시간 1분부터 최대 1시간 | exhausted 상태인 티켓의 실패 원인 확인 → 수동으로 검토 재요청 |
결과
매번 찾던 지식을 QA와 개발, 기획의 공통 기반으로
Go와 Python으로 사내 Agentic RAG 플랫폼을 0→1로 구축했습니다. Jira, Confluence, Git의 자료 수집과 색인, 검색을 하나의 흐름으로 연결하고, 에이전트가 MCP를 통해 필요한 문서와 코드를 추가로 조회하도록 했습니다.
QA에서는 에이전트가 찾은 정책과 코드로 테스트 케이스와 데이터를 빠르게 구성하고, 수기 검수에서 놓쳤던 버그를 추가로 발견했습니다. 개발 지원은 내부 A/B에서 Opus와 Sonnet의 구현 정확도가 각각 6.67%, 5.63% 개선되는 것을 확인한 뒤, MCP 설정과 공통 에이전트 작업 지침을 개발자에게 공유해 적용했습니다.
Jira 정책 검토 워커와 웹 UI, Chrome 확장 프로그램도 구현했습니다. 기획자는 티켓에서 빠진 조건과 모순을 검토받고, 웹과 업무 화면에서는 사내 지식에 질문하고 답변의 출처를 확인할 수 있게 했습니다. 같은 검색 기반을 개발 도구와 기획 티켓, 브라우저에서 활용할 수 있도록 접근 경로를 넓혔습니다.
검색 성능과 자원 사용량, 지식 갱신과 Jira 검토 상태를 Prometheus와 Grafana로 모니터링하는 환경도 구축했습니다. 검색 서버의 대체 처리와 검토 워커의 재시도, 상태 보존을 구성하고, 지표별 확인 기준과 대응 절차를 런북으로 정리했습니다.
E2E, TC, RAG 기반 검증과 Jira 후속 추적을 함께 운영하면서 하루 평균 검증량은 E2E 적용 후 29.2건에서 RAG 적용 후 33.1건으로 늘었고, 배포 후 버그 비율은 3.9%에서 2.9%로 낮아졌습니다. RAG 적용 후 정규 배포(2.16.2~2.22.0)의 QA 대상 티켓 794건 중 배포 후 버그는 23건으로 감소했습니다.
| 지표 | E2E 테스트 적용 전 | E2E 테스트 적용 후 | RAG 적용 후 |
|---|---|---|---|
| 검증 티켓 | 712건 | 992건 | 794건 |
| 하루 평균 검증량 (티켓/일) | 22.3건/일 | 29.2건/일 (약 31% 증가) | 33.1건/일 (약 49% 증가) |
| 배포 후 버그 비율 | 7.0% (50건 / 712건) | 3.9% (39건 / 992건) | 2.9% (23건 / 794건) |